【2026年10月30日発表】AI学習の拒否を「robots.txt」の1行で|OpenAI・Google・Microsoftが共通ルールに対応へ、Anthropicが提出した草案の中身と各社の開始時期・注意点を整理
ただし、このルールはクロール(巡回)そのものを止めるものではなく、まだ正式な標準でもない。対応の開始時期も会社ごとに違う。
この記事では、ITmedia NEWSの報道と、公開されているIETFの草案(Internet-Draft)、Microsoftの公式ブログにもとづいて、何が決まり、何がまだ決まっていないのかを整理する。OpenAIとGoogleの公式発表の本文は今回確認できていないため、その部分は報道ベースとして書く。
① 何が発表されたのか|2026年10月30日に4社が動いた
ITmedia NEWSによると、米OpenAI、米Google、米Microsoftは10月30日(現地時間)、Webサイト運営者がAI学習へのコンテンツ利用について、複数のAI企業へまとめて意向を伝えられる共通の仕組みに対応する方針を、それぞれ発表した。米Anthropicも実装を進めているとされる。
この仕組みのもとになっているのは、Anthropicの標準化担当者ケビン・ケリー氏が同日付でインターネット技術の標準化団体IETFに提出したInternet-Draft(草案)だ。題名は「Machine-Readable Training Preference Signal」。IETFのデータトラッカーでは、2026年10月30日更新、有効期限は2027年5月3日と表示されている。
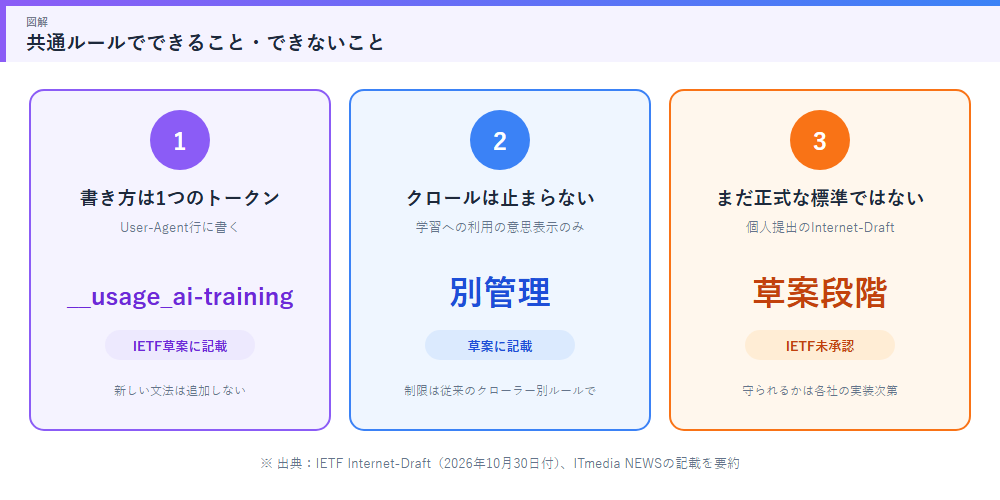
ここで押さえておきたいのは、この草案が個人名義で提出されたもので、IETFとして承認された標準ではない点だ。IETFのAI Preferences(AIPREF)ワーキンググループでの議論をふまえているが、現時点では「提案」の段階にある。
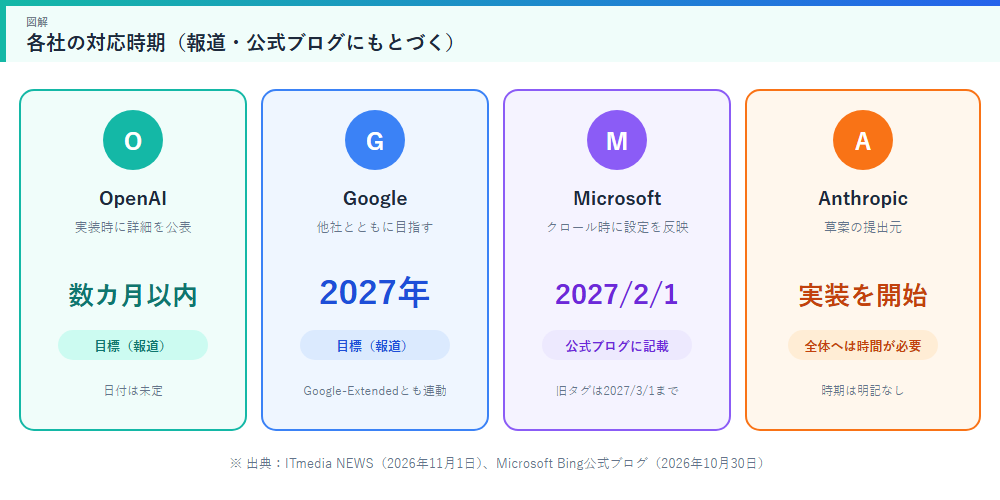
| 会社 | 対応の時期 | 主な内容 | 確度 |
|---|---|---|---|
| OpenAI | 今後数カ月以内を目指す | 実装時に詳細を改めて公表。既存のrobots.txtによるクロール制御は引き続き適用 | 報道のみ(公式本文は未確認) |
| 他社とともに2027年を目指す | 共通ルールで学習を拒否し、Google-Extendedを明示していないサイトは、Google-Extendedも拒否とみなす方針 | 報道のみ(公式本文は未確認) | |
| Microsoft | 2027年2月1日から、クロール時に反映 | 共通ルールに加え、ページ単位の指定にも対応。従来のNoArchive・NoCacheは2027年3月1日までに移行 | 公式ブログに記載 |
| Anthropic | 実装を開始済み(時期の明記なし) | ケリー氏がAIPREFのメーリングリストで報告。サービス全体への展開には時間がかかるとしている | 報道のみ |
※ OpenAIとGoogleは、公式ページの本文を今回の確認では読めていない(OpenAIは403、Googleは記事本文を取得できず)。ITmedia NEWSの記載にもとづく。
② 書き方はどうなる?|__usage_ai-training というトークン
草案が示す書き方は、とても単純だ。robots.txtのUser-Agent行に、__usage_ai-trainingという専用のトークンを書き、その下にDisallow(学習に使わないでほしい)またはAllow(使ってよい)を書く。
Disallow: /
Allow: /press-kit/
ITmedia NEWSが紹介する例では、上の書き方で「/press-kit/以下を除く全ページを、AI学習に使わないでほしい」という意思表示になる。草案は新しい命令や文法を追加しないため、既存のrobots.txtの読み取りには影響しないとされている。
注意したいのが、ワイルドカード(User-Agent: *)のグループは、このトークンには適用されないという点だ。これまで「全ロボット向け」に書いていた設定が、そのまま学習の拒否になるわけではない。また、このトークンを書かなければ、AI学習について何も意思表示していない扱いになる。
「AI学習」の定義は、生成AIモデルの学習済みパラメータを変えるためにコンテンツを使うこととされ、生成以外の用途だけに使うモデルの学習は含まれない。
③ Microsoftだけ細かく公開|ページ単位の指定と「グラウンディング」
4社のうち、設定の中身を最も詳しく公開しているのがMicrosoftだ。10月30日付のBing公式ブログによると、AI学習の指定は、robots.txtの共通ルール(サイト全体またはパス単位)に加えて、ページ単位でも行える。ページ単位では<meta name="Bingbot" content="ai-training:disallow">というmetaタグ、またはHTTPヘッダ(X-Robots-Tag)を使い、ページ単位の設定がrobots.txtより優先される。
さらにMicrosoftは、AIが回答を作るときにWebの内容を参照する「グラウンディング」についても、独自の指定を用意した。こちらはページ単位のみで、サイト全体をまとめて指定するrobots.txtの設定はない。
| 設定値 | 意味 | 備考 |
|---|---|---|
| Allow(既定) | グラウンディングへの利用を許可 | 学習・グラウンディングとも、何も書かなければAllow |
| DisallowExtended | Microsoft自身のサービスでの利用は認め、Web IQやMicrosoft FoundryのAPIなど外部向けの利用は拒否 | ITmedia NEWSは、CopilotやMicrosoft 365を例に紹介 |
| Disallow | グラウンディングへの利用を拒否 | AI体験での表示が大きく減る可能性があると明記 |
※ Bing公式ブログ(2026年10月30日付)の記載を要約。設定は「利用の可否の指定」であり、クロールのアクセス制御ではない。
日程も具体的だ。ブログによると、2026年12月15日から、NoArchive・NoCacheを使っているサイト向けにBing Webmaster Toolsで暫定のグラウンディング設定が開き、2027年2月1日から新しい設定をクロール時に反映する。2027年3月1日以降は、Microsoft(Bing)ではNoArchive・NoCacheが学習にもグラウンディングにも読まれなくなる(Web標準全体の廃止ではない)。グラウンディングの制限を保ちたいサイトは、新しいページ設定とBing Webmaster Toolsの暫定設定の両方が必要になる。
④ 「できないこと」を先に確認|クロールは止まらず、強制力も書かれていない
共通ルールを導入する前に、できないことを整理しておきたい。
| 項目 | 内容 | 確度 |
|---|---|---|
| AI学習への意思表示 | 複数社へ、robots.txtの1か所でまとめて伝えられる | 草案に記載 |
| クロールの停止 | 止められない。クロールを制限したい場合は、各クローラー向けの既存ルールを使う | 草案・報道に記載 |
| 強制力・罰則 | 強制する仕組みや罰則の記載はない。各社が尊重するかどうかに依存する | 報道では言及なし |
| 独自ルールとの関係 | 各社の独自制御や、個別契約が共通ルールより優先される場合がある | 草案に記載 |
| すでに学習済みのデータ | 記事・草案とも、過去の学習分の扱いには触れていない | 未確認 |
※ 「記載がない」ことは「対応しない」ことを意味しない。詳細は各社の今後の発表を待つ必要がある。
⑤ サイト運営者は今どうすればいい?|考え方の整理
ここからは、報道と草案をふまえた考え方の整理で、公式の推奨手順ではない。実際の導入は、各社の正式な対応開始を確認してからが安全だ。
まず、「学習に使われたくない」と「AIの回答で紹介されたい」は別の問題だと考えるとよい。ITmedia NEWSによると、GoogleはGoogle-Extendedを明示的に許可したサイトについて、Geminiアプリのグラウンディングの対象となり、回答内で紹介されてクリックを得る可能性があると説明している。Microsoftも、グラウンディングを拒否するとAI体験での表示が大きく減ると注意している。
つまり、学習を拒否することと、AIの回答で見つけてもらうことは、ときにトレードオフになる。自社のコンテンツがどちらを重視するのか(たとえば、有料記事は守りたい、店舗情報は見つけてほしい、など)を、ページの種類ごとに整理しておくと、後で設定しやすい。
もう一つは、すでに使っている設定を見直すことだ。MicrosoftのNoArchive・NoCacheを使っているサイトは、2027年3月1日までに移行が必要になる。Google-Extendedを指定しているサイトは、共通ルールが導入された後も、その指定は引き続き使えると報じられている。
⑥ まとめ:標準化の入口に立った、ただし「今すぐ全社に効く」わけではない
この記事のまとめ
- 2026年10月30日、OpenAI・Google・Microsoftが、robots.txtでAI学習の意向を伝える共通ルールへの対応方針を発表。Anthropicも実装を進めていると報じられた
- 書き方は
User-Agent: __usage_ai-trainingの下にDisallow/Allow。ワイルドカード(*)のグループは対象外 - このルールはクロールを止めない。あくまで学習利用についての意思表示で、強制力の記載はない
- 開始時期は、OpenAIが数カ月以内、Googleが2027年、Microsoftが2027年2月1日。Anthropicは時期の明記なし
- 提案は個人提出の草案でIETFの正式な標準ではない。「学習の拒否」と「AI回答での紹介」はトレードオフになりうる
生成AIの学習とWebサイト運営者の権利をめぐっては、意思表示の方法が会社ごとにバラバラなのが大きな課題だった。今回、競合する主要各社が同じ日に歩調をそろえたこと自体が、ニュースとしての大きなポイントだ。一方で、実際に守られるかどうかは、各社の実装と運用が始まってから確かめるしかない。この記事は2026年11月2日時点で確認できた情報にもとづく。草案の内容や各社の対応時期は今後変わる可能性があるため、最新の情報は各社の公式発表とIETFのページで確認してほしい。
おすすめAIツール
- ChatGPT(OpenAI):幅広い用途に使える対話AI → https://chatgpt.com/
- Claude(Anthropic):文書作成や分析に強いAI → https://claude.ai/
- Gemini(Google):調べ物や資料整理に強いAI → https://gemini.google.com/
- Perplexity:出典つきで調べられるAI検索 → https://www.perplexity.ai/
参考リンク: ITmedia NEWS / IETF Internet-Draft / Microsoft Bing公式ブログ