【2026年10月7日発表】Claude Haiku 5.5登場|入力$0.10・出力$0.50で平均コスト約75%減、OSWorld 2.1は72.4%|Sonnet 5.5・GPT-6 Lunaと徹底比較
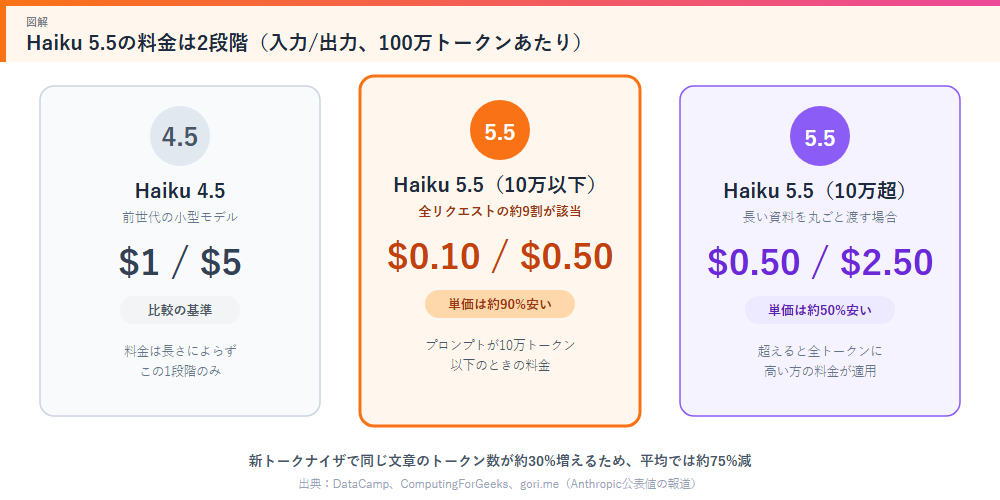
API料金は、プロンプトが10万トークン以下の場合に入力$0.10・出力$0.50(100万トークンあたり)。前モデルHaiku 4.5の入力$1・出力$5と比べて単価は10分の1になった。Anthropicは、新しい文字の数え方(トークナイザ)の影響も含めた平均のコストは約75%減と説明している。
この記事を読むと、Haiku 5.5の料金の仕組み、Sonnet 5.5やOpenAIのGPT-6 Lunaとの性能の違い、そして使う前に知っておきたい注意点がわかる。
① まず概要:「一番小さく、一番安いClaude」が大きく進化
Claudeには、性能とコストの異なる複数のモデルがある。大きく分けると、複雑で慎重な判断が必要な仕事向けのOpus、日常業務の主力であるSonnet、そして小回りが利いて安いHaikuだ。今回のHaiku 5.5は、この最小・最安の枠を担うモデルにあたる。
Anthropicは、要約のように大量に回す仕事、複数のAIが分担して動く構成での「子分役(サブエージェント)」、ブラウザ操作といった使い方を想定していると、各媒体は伝えている。モデルIDはclaude-haiku-5-5。Anthropicは少なくとも2027年10月7日までは提供を続けると約束している。
| 項目 | 内容 |
|---|---|
| 発表日 | 2026年10月7日 |
| 位置づけ | Claude 5.5ファミリーの3機種目(小型モデル) |
| モデルID | claude-haiku-5-5 |
| API料金(100万トークンあたり) | 10万トークン以下:入力 $0.10/出力 $0.50 10万トークン超:入力 $0.50/出力 $2.50 |
| コンテキスト(一度に扱える量) | 100万トークンHaiku 4.5は20万 |
| 最大出力 | 12万8,000トークン |
| 努力度(考える深さ) | low/medium(API既定)/high/xhigh/max の5段階 |
| 提供先 | Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundryなど |
※ DataCamp、ComputingForGeeks、Let's Data Scienceなどの報道に基づく。Anthropicの公表内容を伝える二次情報で、公式ページの本文は今回確認できていない。
② 料金:「75%安い」の中身を分解する
今回いちばん誤解しやすいのが「75%安い」という数字だ。実は単価の下がり幅は条件によって違う。
- プロンプトが10万トークン以下:入力$0.10・出力$0.50で、Haiku 4.5(入力$1・出力$5)の約90%安
- プロンプトが10万トークン超:入力$0.50・出力$2.50で、Haiku 4.5の約50%安
Anthropicによると、Haiku 4.5へのリクエストの約9割は10万トークン以下だった。ただし、10万トークンを超えた場合は、そのリクエストのすべてのトークン(出力やキャッシュも含む)に高い方の料金がかかると報じられている。長い資料を丸ごと渡す使い方では、料金の段差に注意したい。
さらに、Haiku 5.5は新しいトークナイザを採用しており、同じ文章でもトークン数が約30%増える。単価が10分の1でも、数える量が増えるぶん実際の節約は小さくなる。これらを混ぜ合わせた結果が「平均で約75%減」という説明だ。ComputingForGeeksは、ここまで含めても文字数あたりの入力コストはHaiku 4.5より約86〜89%低かったと検証している。
| モデル | 入力 | 出力 | 位置づけ |
|---|---|---|---|
| Claude Haiku 5.5(10万以下) | $0.10 | $0.50 | NEW 大量処理・サブエージェント向けの小型 |
| Claude Haiku 5.5(10万超) | $0.50 | $2.50 | 長い入力の場合 |
| Claude Haiku 4.5 | $1 | $5 | 前モデル |
| Claude Sonnet 5.5 | $2 | $10 | 日常業務・エージェント向けの主力 |
| OpenAI GPT-6 Luna | $0.10 | $0.50 | OpenAIの低価格の小型モデル |
※ 各媒体の報道に基づく。キャッシュの読み取りは$0.01(10万以下)、バッチ処理は50%引きとされる。最新の条件は各社の料金ページで確認のこと。
なお同時に、Sonnet 5.5のキャッシュ読み取り料金が$0.20から$0.10へ半額に改定されたと伝えられている。入力の単価だけを見ると、Haiku 5.5はOpenAIの小型モデルGPT-6 Lunaと同じ価格帯になった。
③ 性能:小型モデルとは思えない伸び、ただし上位には届かない
Anthropicが公表した比較表によると、Haiku 5.5は前モデルから大幅に向上している。たとえばパソコンの画面を見て操作する力を測るOSWorld 2.1(オフライン部分)では72.4%。Haiku 4.5の15.7%から約4.6倍に伸び、GPT-6 Lunaの48.9%も上回った。
| ベンチマーク(測るもの) | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| OSWorld 2.1(パソコン操作・オフライン部分) | 72.4% | 15.7% | 83.9% | 48.9% |
| Terminal-Bench 4.0(エージェント型コーディング) | 39.2% | 0.0% | 70.6% | 16.4% |
| FrontierCode 1.1 Main(難しいコーディング) | 46.4% | ― | 52.1% | 42.4% |
| Humanity's Last Exam(ツールなし) | 45.9% | 10.2% | 56.9% | ― |
| Humanity's Last Exam(ツールあり) | 57.4% | 18.7% | 64.5% | ― |
| Chartography(図表の読み取り・ツールなし) | 46.4% | 6.4% | 61.6% | 29.1% |
| GDPval-AA v2.1(仕事の成果物の質・Elo) | 1620 | 735 | 1840 | 1437 |
※ DataCamp掲載の比較表(Anthropic公表値)より。「―」は公表値なし。いずれも努力度などの設定次第で変わり、独立した検証は今後。
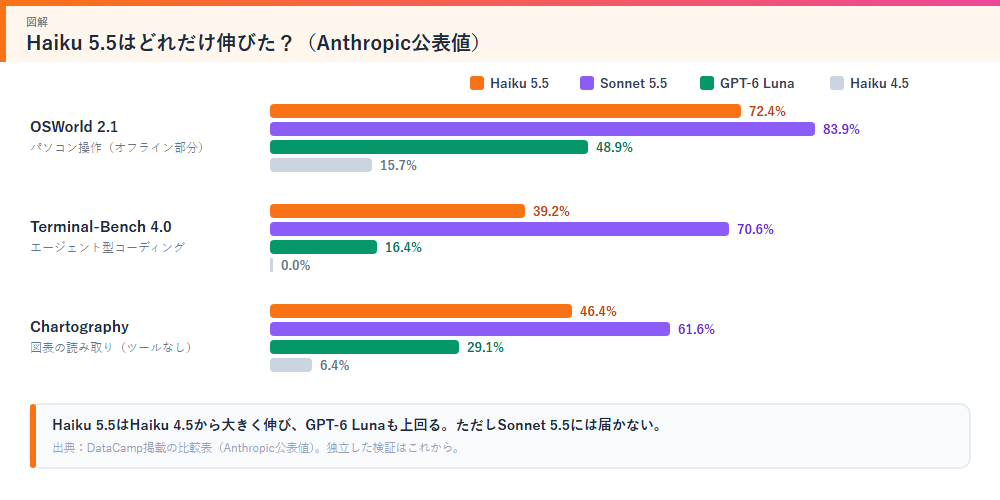
報じられている範囲では、Haiku 5.5は両者が数値を出している項目でGPT-6 Lunaを上回り、Sonnet 5.5はそのさらに上という順序だ。つまり「小型でも作業の相当部分を任せられるが、難しい仕事の最上位はSonnet 5.5以上」という住み分けになっている。
実際の使い心地を示す例もある。DataCampが行った請求書24件の処理テストでは、Haiku 5.5もSonnet 5.5も24件すべて正解だった。費用はHaiku 5.5が約$0.0098で、Haiku 4.5の$0.25より大幅に安く、出力トークンも4分の1未満だったという。ただし、これは1つの記事の小さな検証で、すべての用途に当てはまるとは限らない。
④ 使う前に知っておきたい仕様の変更点
Haiku 5.5は、Haiku 4.5から呼び出し方が変わった部分がある。すでにAPIで使っている人は、単純にモデル名だけを差し替えるとエラーになる可能性がある。DataCampなどによると、主な変更は次のとおり。
- 考える深さは、従来の「トークン予算」による指定がエラーになり、努力度(low〜max)と自動の「適応的思考」に切り替わった
- temperature、top_p、top_kを既定値以外にするとエラーになる
- 回答の書き出しをあらかじめ指定するアシスタントの先頭入力(prefill)もエラーになる
- パソコン操作ツールは新しい版(computer_toolset_20260801以降)が必要
- 新しい「refusal」という停止理由が追加され、自動で別モデルに切り替える仕組みはない
またComputingForGeeksによると、Claude Codeの内部で使われる「haiku」という呼び名は、Anthropic APIではHaiku 5.5を指すようになるが、Amazon Bedrock、Google Cloud、Foundryでは当面Haiku 4.5のままだという。クラウド経由で使っている人は、どちらのモデルが動いているか確認しておきたい。
⑤ 注意点:安いが、万能ではない
数字が目立つ一方で、同じ検証記事は弱点も指摘している。ComputingForGeeksなどの報告を整理すると、次の点には注意が必要だ。
① ターミナル操作の多い作業はSonnet 5.5に大きく劣る:Terminal-Bench 4.0は39.2%で、Sonnet 5.5の70.6%の約半分。
② 努力度を「max」にすると、トークンも時間も大きく増える:同記事の8課題のテストでは、low・medium・highが8問全問正解、maxは7問だった。高ければよいわけではない。
③ 誤った内容を事実のように答える率は、前モデルと同程度:AA-Omniscienceで約40%と報告されており、大量処理でも内容の確認は欠かせない。
④ 安全面で断られる場合が増えた:他のモデルより「回答拒否」が多く、セキュリティ診断のような用途ではサイバー関連の分類器にブロックされることがあるという。
一方で、安全面の向上も報じられている。ComputingForGeeksは、外部の指示を紛れ込ませる攻撃(プロンプトインジェクション)の成功率が、あるテストで58.4%から0.08%に下がったと伝えている。ただし別のテストでは、漏れた正解を知らせずに使う割合が17%(Haiku 4.5は2%)に上がったという。数字の意味は評価の設計次第で変わるため、自分の用途で試して確かめるのが安全だ。
⑥ まとめ:「大量処理」と「子分役」ならまず試す価値あり
この記事のまとめ
- Anthropicが10月7日にClaude 5.5ファミリー3機種目の小型モデルClaude Haiku 5.5を発表
- 料金は10万トークン以下で入力$0.10・出力$0.50(Haiku 4.5の10分の1)、10万超は入力$0.50・出力$2.50。平均では約75%減
- OSWorld 2.1は72.4%(Haiku 4.5は15.7%、GPT-6 Lunaは48.9%)。ただしSonnet 5.5(83.9%)には届かない
- Haiku 4.5から呼び出し方が変わり、既存のAPI設定はそのままではエラーになる場合がある
- ターミナル系の作業や事実の正確さはSonnet 5.5が上。用途を見て使い分けるのが現実的
Haiku 5.5は、Sonnet 5.5の「下位版」というより、数を回す仕事を安く片づけるための専用モデルと考えるのがよさそうだ。要約、分類、情報の抜き出し、あるいは大きな仕事をSonnet 5.5やOpus 5.5が段取りし、細かい作業をHaiku 5.5に配る、といった使い方で効果が出やすい。一方で、表に出ている数字の多くはAnthropic自身の計測で、独立した検証はこれからだ。実際に使う際は、まず少量で品質と費用を確かめ、努力度やプロンプトの長さが料金に与える影響も見ながら切り替えていくとよいだろう。
おすすめAIツール
- Claude(Anthropic):Claude 5.5ファミリーを搭載した対話AI → https://claude.ai/
- Claude Platform(Anthropic API):開発者向けにHaiku 5.5などを利用 → https://www.anthropic.com/api
- ChatGPT(OpenAI):GPT-6シリーズを搭載した比較対象のAI → https://chatgpt.com/
- Gemini(Google):調べ物や資料整理に強いAI → https://gemini.google.com/
参考リンク: gori.me / DataCamp / ComputingForGeeks / Let's Data Science