【2026年10月6日発表】Google「EmbeddingGemma 2」登場|文字・画像・動画・音声を1つの検索空間に、740Mでスマホ動作・Apache 2.0で公開
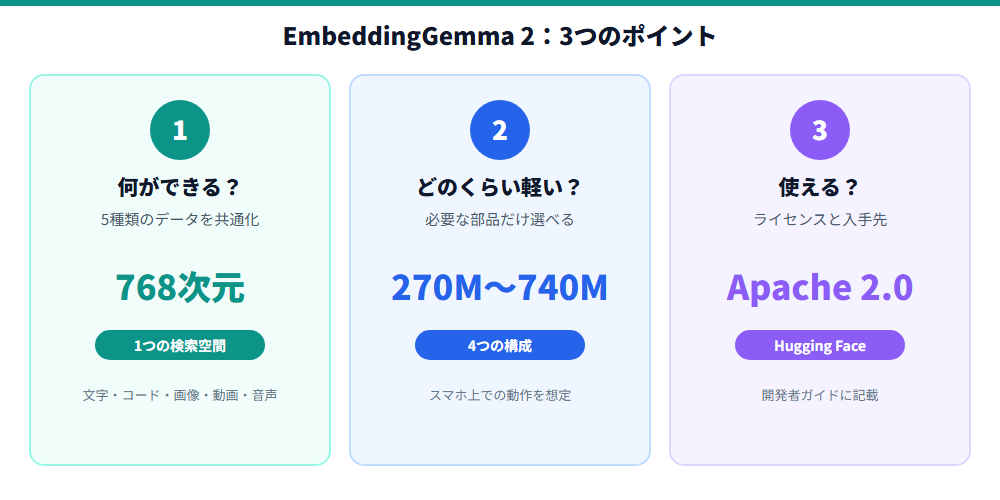
モデルの大きさは270M〜740M(パラメータ)と小さく、スマホ上で動かす使い方も想定されている。開発者向けガイドによれば、ライセンスはApache 2.0で、重みはHugging Faceで入手できる。
この記事では、そもそも「埋め込みモデル」とは何か、今回何が新しいのか、構成とサイズ、保存容量を減らす仕組み、使いどころと注意点を、専門用語をなるべく避けて整理する。
① そもそも「埋め込みモデル」とは? 文章や画像を“数字の座標”に変える仕組み
ChatGPTやClaudeのような「文章を作るAI」とは別に、「意味の近さ」を測るためのAIがある。それが埋め込みモデル(エンベディングモデル)だ。
やっていることは、文章や画像を、数百個の数字の並び(ベクトル)に置き換えることだ。地図で言えば、場所を「緯度と経度」で表すようなものだ。意味が近いものは近い座標に、遠いものは遠い座標に置かれる。たとえば「犬の散歩」という文章と、犬を散歩させている写真が、同じ座標の近くに来るように作られている。
この仕組みは、次のような場面で裏方として働いている。
- 社内文書の検索:キーワードが一致しなくても、意味が近い文書を探せる
- RAG(検索拡張生成):AIが答える前に、関連する資料を探して渡す仕組み
- 写真・動画・音声の検索:「海辺で笑っている場面」のような説明で探す
EmbeddingGemma 2は、この「座標に変える部分」を担うモデルで、文章を書くAIではない。ここを最初に押さえておくと、以下の話が分かりやすくなる。
② 今回何が新しいのか:前世代は「文章中心」、今回は5種類を1つの空間に
開発者ガイドによると、EmbeddingGemma 2はGoogleのオープンモデル「Gemma 4」をもとに作られた、10億パラメータ未満(sub-1B)のモデルだ。
最大の変化は対応するデータの種類だ。前世代のEmbeddingGemma 1は文章が中心だったが、今回はテキスト、コード、画像、動画、音声を、すべて同じ768次元の空間に変換する。種類の違うデータを同じ空間に置くので、「文章で検索して、動画の該当シーンを見つける」といった使い方ができる。
性能面では、ガイドが挙げる数字はMTEB(Code)で前世代より14%高いという点だ。コード検索や技術情報の検索が大きく改善したとされる。一方、多言語の文章の精度は前世代を維持したと説明されている。それ以外の数値は図表(画像)で示されており、本記事では扱わない。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年10月6日(公式ブログの日付) |
| 開発元 | Google(Google DeepMind/Google Developers Blog) |
| 土台 | Gemma 4をもとにした10億パラメータ未満のオープンモデル |
| 対応データ | テキスト、コード、画像、動画、音声 |
| 出力 | 768次元の共通ベクトル空間(128〜512次元へ短縮可能) |
| 入力の長さ | 全データ種類で共通8,192トークン |
| ライセンス | Apache 2.0(開発者ガイドの記載) |
| 入手先 | Hugging Face(google/embeddinggemma-2) |
※ Google Developers Blogの開発者ガイドに基づく。エッジ向け解説記事ではライセンスの明記がなく「オープンウェイト」とのみ記載されている。
③ 4つの構成:必要な部品だけ選べる“モジュール式”
EmbeddingGemma 2は、1つのモデルを丸ごと使うのではなく、必要な部品(エンコーダー)だけを選んで読み込める作りになっている。文章・コード用の本体に、画像用と音声用の部品を追加していくイメージだ。
ガイドによると、追加される部品の大きさは、画像用が約170M、音声用が約300Mだ(ガイドの表現は「スピーチとサウンド用」)。組み合わせごとの大きさは次のとおりで、すべて同じ配布ファイル(チェックポイント)から読み込め、同じベクトル空間を共有すると説明されている。
| 構成 | 対応するデータ | パラメータ数 |
|---|---|---|
| テキスト+コード | 文章・プログラム | 270M |
| テキスト+画像 | 文章・プログラム・画像 | 440M |
| テキスト+音声 | 文章・プログラム・音声 | 570M |
| すべて | 文章・コード・画像・動画・音声 | 740M |
※ Google Developers Blog開発者ガイドに基づく。動画は既定で1秒あたり1フレームを取り出して扱う。音声は16kHzのモノラルが推奨。
スマホなどの小さな機器では、この「選べる」点が効く。文章検索だけが目的なら、画像や音声の部品を読み込まずに済む。エッジ向けの解説記事では、Pixel 11 Pro上のメモリ使用量が、文章のみで約191MB、すべてを読み込んで約567MBと紹介されている(Google自身の測定値で、第三者の検証ではない)。
④ 保存容量を減らす仕組み:ベクトルを「短く切る」
検索システムでは、データ1件ごとにベクトルを保存する。件数が増えると、保存容量と検索の負担が大きくなる。そこで使われるのがマトリョーシカ型の学習(MRL)だ。ロシアの入れ子人形のように、先頭の数字だけを切り出しても、ある程度の意味が保たれるよう学習されている。
開発者ガイドによれば、768次元のベクトルを512、256、128次元に短縮して使える。短縮した場合の目安は次のとおりだ。
| 次元数 | 保存容量の目安 | 文章・コード検索の品質 | 画像・動画・音声検索の品質 |
|---|---|---|---|
| 768(そのまま) | 100万件で約1.5GB | 基準 | 基準 |
| 256 | 約3分の1 | フル品質の大部分 | 約95% |
| 128 | 約6分の1(100万件で約250MB) | 約90% | 約75% |
※ 保存容量はbfloat16形式で100万件を保存した場合の例。品質は768次元との比較でGoogleが示した目安。エッジ向け記事では、短縮による保存容量・インデックスの削減は「最大8倍」とも紹介されている。
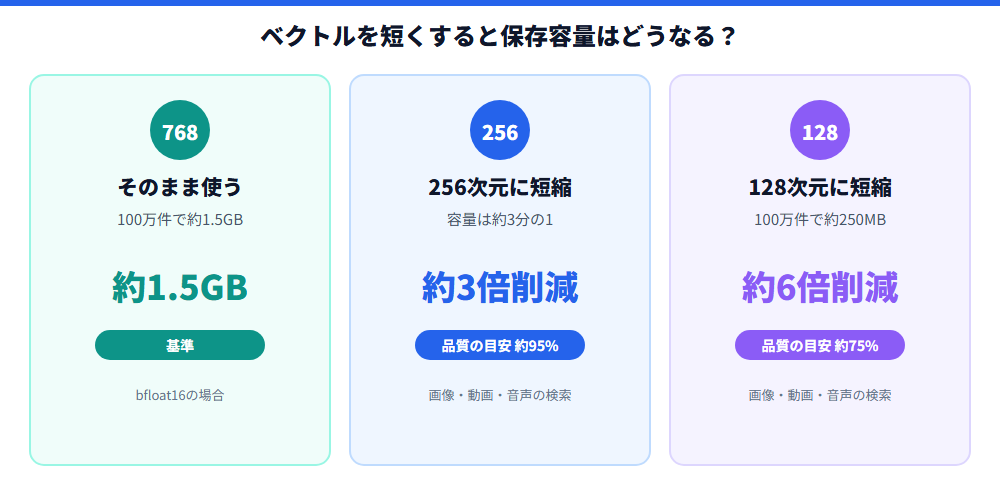
ここで注意したいのは、短くするほど軽くなるが、特に画像・動画・音声では精度の低下が目立つという点だ。ガイドは、検索側(質問)と保存側(資料)で同じ次元数をそろえる必要があるとも説明している。 小さな文書検索なら128次元でも足りるかもしれないが、写真や動画の検索では256次元以上のほうが安心、というのが表の読み方だろう。
⑤ どこで使える? スマホ・Mac・ブラウザまで想定
EmbeddingGemma 2は、クラウドだけでなく手元の機器で動かすことが強く意識されている。エッジ向けの解説記事によると、次のような実行環境が用意されている。
- LiteRT:1つの.litertlmファイルで、CPU・GPUに加え、対応機器ではNPU(AI専用チップ)も使って動かせる。ブラウザ(WASM)にも対応
- MediaPipe Tasks:iOS、macOS、Windows、Linux、Webで使える部品(埋め込み、意味検索、判断用)
- ML Kit:Android向けのサービスで、「今後数週間」で提供予定とされている
- ほかに、Hugging Face Transformers、sentence-transformers、vLLM、SGLang、MLX、Ollama、LM Studioなどで使える(開発者ガイド)
速度の例として、記事はMacBook M5 Pro のGPUで、画像1枚の埋め込みに37.3ミリ秒(毎秒26.9枚)と紹介している。また、判断用の部品は100ミリ秒未満で応答し、チェスのデモでは1回に500通りの手を評価した、とされる。いずれもGoogleが示した数値で、条件によって変わる点には注意が必要だ。
利用例としては、端末内の写真・動画を文章で探す「メディア検索」、動画の中から言葉に合う場面を見つけるツール、AIエージェントがコードを検索するデモなどが紹介されている。端末内で処理すれば、個人の写真や会議の録音を外部に送らずに検索できる可能性がある。ただし、実際にどう動くかは各アプリの作りによる。
EmbeddingGemma 2は、チャットで答えるAIを置き換えるものではない。AIが答える前の“探す”部分を、小さく・手元で・多様なデータに対応させるための部品だ。RAGや社内検索、アプリ内検索を作る開発者向けの発表であり、一般の利用者がすぐ触れる新機能ではない。
今回の発表は、主に「アプリやサービスを作る人」向けの部品の話です。すぐにあなたのスマホに新機能が入る、というものではありません。ただ、今後「写真を文章で探せる」「録音から話した場面を探せる」といった機能が増える背景にある技術なので、名前だけ知っておくと役に立ちます。
⑥ 使う前に知っておきたい注意点
ここまでの数字は、すべてGoogle自身の発表に基づく。第三者による独立した検証や、他社の埋め込みモデルとの詳しい比較は、本記事の時点では確認できていない。導入を考えるなら、次の点を自分のデータで試したほうがよい。
- 自分のデータで精度を確かめる:日本語や専門用語の多い資料では、数字どおりにいかないことがある
- 次元の短縮は目的に合わせて:品質の低下は、データの種類によって差がある
- 入力の長さの上限:全データ種類で共通8,192トークン。長い資料は分割が必要
- ML Kitは準備中:Android向けのサービスは「今後数週間」とされており、すぐには使えない
- ライセンスの確認:開発者ガイドにはApache 2.0とあるが、商用で使う場合は配布元の記載を必ず確認する
この記事のまとめ
- Googleは2026年10月、オープンな埋め込みモデルEmbeddingGemma 2を公開した(公式ブログの日付は10月6日)
- 文章・コード・画像・動画・音声を、同じ768次元の空間に変換でき、種類をまたいだ検索ができる
- 構成は270M〜740M。必要な部品だけ読み込め、Pixel 11 Proで文章のみ約191MB、全部で約567MB(Google測定)
- ベクトルを256次元に短縮すると約3分の1、128次元で約6分の1の容量に。ただし画像・動画・音声では精度低下が大きくなる
- 前世代よりMTEB(Code)が14%向上。ライセンスはApache 2.0、Hugging Faceで入手可能
⑦ まとめ:派手さはないが、「AIが探す力」を手元に持ってくる発表
EmbeddingGemma 2は、話題になりやすい“新しいチャットAI”ではない。ただ、RAGや社内検索、写真・動画の検索など、実際のアプリを支える地味で重要な部分を、小さく、オープンに、複数のデータ種類へ広げた発表だ。
今後の焦点は、日本語を含む実データでの精度、他社モデルとの独立した比較、そしてML Kit経由でAndroidアプリにどれだけ早く載るかだろう。続報が出た段階で、改めて整理したい。
おすすめAIツール
- ChatGPT(OpenAI):汎用AIアシスタント → https://chatgpt.com/
- Claude(Anthropic):対話型AIアシスタント → https://claude.ai/
- Gemini(Google):Google製のAIアシスタント → https://gemini.google.com/
参考リンク: Google Developers Blog(開発者ガイド) / Google Developers Blog(AI Edge)