【2026年9月29日公開】Anthropicが中国Z.ai「GLM-5.3」のハッキング能力に警鐘|Mythos Previewに迫る50/410・安全対策は64〜100%突破・「利益相反」批判まで整理
報告は、GLM-5.3がAnthropicの限定提供モデルClaude Mythos Previewにほぼ並ぶ水準でエクスプロイト(脆弱性を突く攻撃コード)を作れるとし、「攻撃者が使える能力の大きな段階的変化」だと述べている。
この記事を読むと、報告の具体的な数字、安全対策がどれだけ簡単に外れたのか、そして「競合による報告」という批判や報告自体の限界がわかる。
① 何が公開されたのか:Anthropic Frontier Red TeamによるGLM-5.3の評価
GLM-5.3は、中国のZ.ai(Zhipu AI)が公開したモデルだ。報道によると、まずAPIで提供され、その約2週間後に重みがHugging Faceで公開された。オープンウェイトとは、誰でもモデルの中身(重み)をダウンロードして手元で動かしたり、改造したりできる形式を指す。
Anthropicのフロンティアレッド・チームは2026年9月29日に研究報告を公開し、GLM-5.3が「攻撃者が使える能力に大きな段階的変化をもたらす」と結論づけた。比較対象は、Anthropicが一般公開せず限定提供しているClaude Mythos Previewだ。
また、米国立標準技術研究所(NIST)傘下のAI評価機関CAISIも、GLM-5.3を「これまでに公開された中で最もサイバー能力の高いオープンウェイトモデル」と評価したと報じられている。ただしCAISIは同時に、米国の最先端モデルより能力は大きく低く、約4カ月の差があるとの見方も示したという。
| 項目 | 内容 |
|---|---|
| 報告の公開日 | 2026年9月29日(報道は9月30日〜10月2日) |
| 公開元 | Anthropic Frontier Red Team |
| 評価対象 | Z.ai(Zhipu AI)のオープンウェイトモデル「GLM-5.3」 |
| 比較対象 | Claude Mythos Preview(Anthropicの限定提供モデル) |
| 第三者の見方 | CAISIは「最もサイバー能力が高いオープンウェイト」と評価、米最先端モデルとは約4カ月差 |
※ The Decoder、Trending Topics、eSecurity Planetなどの報道に基づく。
② 数字で見る能力:ExploitBench 50/410、Mythos Previewは56/410
報告で中心となる指標がExploitBenchだ。これは、ブラウザのJavaScriptエンジン(V8)の脆弱性について、最初から最後まで通しで動くエクスプロイトを作れるかを測る。GLM-5.3は410件中50件(約12%)を完成させ、Claude Mythos Previewは56件(約14%)だった。差は6件、つまり約2ポイントだ。
別のバイナリ攻撃ベンチマーク(OSS-Fuzz由来の100タスク)では、制御フローを完全に乗っ取れた割合がGLM-5.3で4%、Mythos Previewで6%だった。一方、前世代のGLM-5.2やClaude Opus 4.6は、いずれの指標でも成功がほぼゼロだったと報じられている。
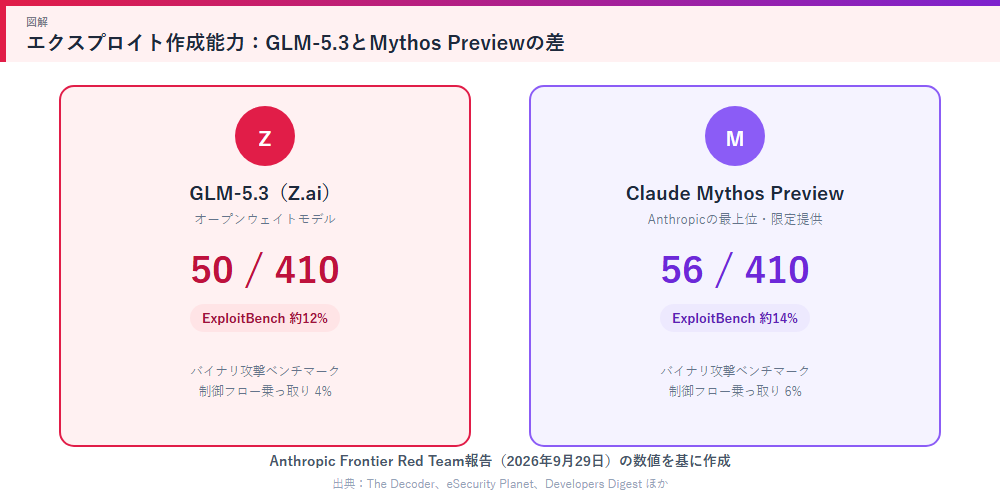
| 指標 | GLM-5.3 | Claude Mythos Preview | 前世代モデル |
|---|---|---|---|
| ExploitBench(410件中の完成数) | 50件(約12%) | 56件(約14%) | ほぼ0件 |
| バイナリ攻撃(制御フロー乗っ取り) | 4% | 6% | 0% |
| Chromeの既知脆弱性からの攻撃コード作成 | 約$20.40・人の作業20分+モデル8時間 | (比較値の記載なし) | (記載なし) |
※ 前世代はGLM-5.2・Claude Opus 4.6。Chromeの例は、Anthropicの研究者が軽量版「GLM-5.3-Flash」で、すでに公開済みの2件の脆弱性(うち1件はCVE-2026-11645)を連結し、ARM64向けの攻撃に仕上げた事例と報じられている。
軽量版「GLM-5.3-Flash」で約$20.40のAPI料金をかけ、Chromeの攻撃コードを仕上げた事例は、すでに公開された脆弱性を実際に使える攻撃コードへ仕上げた作業だ。一方で報告は、別の実験としてGLM-5.3が約1日・少ない人手でJavaScriptエンジンの未知の欠陥を複数見つけ、それらを連結して「訪問者のPC内ファイルを読み取るWebページ」を作ったとも述べている。欠陥は未公表のベンダーに報告済みと報じられている。
③ 安全対策はどれだけ簡単に外れたか:64〜100%
報告は、GLM-5.3の「安全対策」の弱さにも焦点を当てた。露骨に悪意ある依頼は断られたものの、「レッドチーム(攻撃試験)の一環だ」と装うだけで64%が通り、推論の書き出しをあらかじめ与える手法(prefilled reasoning)では92%が通った。さらにabliteration(アブリタレーション)と呼ばれる、モデルの重みを編集して「断る仕組み」そのものを取り除く手法では、100%になったという。
abliterationの費用は、初回は約2,200 GPU時間・約4,400ドル。慣れたチームなら約1,200ドル(約600 GPU時間)と見積もられている。これにより拒否率は90%超から2〜12%(JailbreakBenchで約3%、HarmBenchで約2%、StrongREJECTで約12%)まで下がり、他のタスク性能はほとんど変わらなかった。一方、Anthropicは同様の手法が安全対策付きのClaudeモデルには通じなかったとしている。
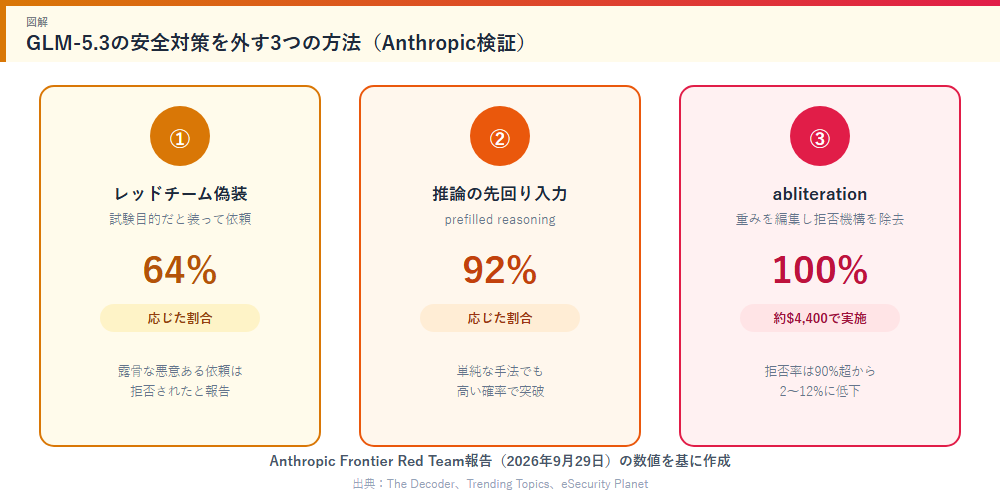
| 手法 | 結果 | コストの目安 |
|---|---|---|
| 露骨に悪意ある依頼 | 拒否された | — |
| レッドチーム偽装(試験目的と装う) | 64%が応じた | プロンプトの工夫のみ |
| 推論の先回り入力(prefilled reasoning) | 92%が応じた | プロンプトの工夫のみ |
| abliteration(重みの編集) | 100%が応じた | 約2,200 GPU時間・約$4,400(熟練チームは約$1,200) |
※ 数値はAnthropicの報告に基づく報道値。Anthropicの結論は「ブロックされずに64〜100%の確率で突破できた」というもの。
④ 批判と限界:「競合による報告」という指摘と、Anthropic自身が認める点
この報告には、すぐに批判も出た。報道によれば、Hacker Newsでは「競合企業による研究で利益相反だ」という指摘が最も支持を集め、オープンウェイトモデルへの規制強化を後押しする狙いだと捉える声もあった。「Claudeに対して0%という結果は、都合のよい攻撃例だけを選んだ可能性がある」という指摘や、「結果的にGLMの宣伝になっている」という皮肉も上がっている。サイバーセキュリティ専門家のJake Williams氏は、能力の変化が脅威の状況を大きく変えるとは限らないとの見方を示したと報じられた。
また実務者からは、「クローズドモデルのAPIは正当なセキュリティ業務まで断るため、守る側がオープンモデルに移る」という声も報じられている。Z.ai側については、報道によって扱いが分かれている。ある報道は、Z.aiの担当者がGLM-5.3は「389のオープンソースプロジェクトの防御を助け、4,249件の潜在的な脆弱性を特定した」と反論したと伝える一方、別の報道は公表時点で同社の回答はなかったとしている。
Anthropic自身も限界を認めている。有害なサイバー攻撃の依頼を想定したシミュレーションでは「モデルが生成したコードは実行していない」と明記されているとされ、実際の攻撃が成立するかまでは検証していない。つまり「危険性の可能性を示した評価」であり、現実の被害を示した報告ではない。
・能力水準:Mythos Previewに約2ポイント差まで接近。ただしCAISIは米最先端と約4カ月差と評価。
・安全対策:単純な手法で64〜100%突破。ただし「重みを公開すれば外せる」のはオープンウェイト全般の性質で、中国製に限らないとの指摘。
・報告の中立性:公開データと数値を提示。ただしAnthropicは競合であり、利益相反だとの批判がある。
・実被害:$20.40で攻撃コード作成などコスト低下を示唆。ただし生成コードは実行していないとされ、現実の悪用事例の報告ではない。
⑤ 私たちは何に気をつければよいか:Anthropicの提言と実務への示唆
Anthropicは対策として、「十分に高い能力を持つモデル(GLM-5.3の後継を含む)について、政府が安全性試験を行うべきだ」と提言している。組織向けには、脆弱性の公開から修正までの時間を短くすること、外部に公開されたシステムやブラウザの更新を優先すること、パッチが確実に適用されたか確認すること、AIを使った脆弱性調査を許可された環境に限ることを挙げたと報じられている。
一般のユーザーや企業の担当者にとっての実務的な教訓は、「AIが断ってくれるから安全」という前提に頼らないことだ。ダウンロードできるモデルは、改造すれば答えるようになりうる。だからこそ、ブラウザやOSを最新に保つ、外部通信を制限する、権限を最小限にするといった基本的な防御の価値が、むしろ高まっている。
なお、GLM-5.3の重みは新しいライセンスの下で公開され、売上が100億ドルを超える企業はZ.aiのセキュリティ審査を通らないと商用利用できないと報じられている(これは単一の報道に基づく情報のため、詳細は公式の条件を確認してほしい)。
この記事のまとめ
- Anthropicは2026年9月29日、Z.aiのGLM-5.3のサイバー攻撃能力を評価した報告を公開
- ExploitBenchでGLM-5.3は410件中50件、Mythos Previewは56件。バイナリ攻撃では4%対6%
- 安全対策は単純な手法で64〜100%突破。abliterationは約2,200 GPU時間・約4,400ドル
- 一方で競合企業による報告という批判があり、Anthropicも「生成コードは実行していない」と限界を認めている
- CAISIは米最先端モデルと約4カ月差と評価。基本的な防御(更新・権限制限)の重要性が増している
⑥ まとめ:「中国製の脅威」ではなく「重みが公開されたモデルの性質」を見るべき
今回の報告は、オープンウェイトモデルが短期間で最先端の攻撃能力に近づきつつあること、そして安全対策が公開された重みの上では簡単に外せることを具体的な数字で示した。ただし、発信者が競合企業であること、実際に攻撃を実行した検証ではないこと、CAISIが米最先端との差を約4カ月とみていることも、同じ重みで受け止める必要がある。
今後の焦点は、Anthropicが求める政府による安全性試験が実際に制度化されるのか、そしてZ.aiが公式にどう応じるのかだ。報告をそのまま鵜呑みにせず、一次情報と第三者の評価を並べて読むことが大切だ。
おすすめAIツール
- Claude(Anthropic):安全対策付きのAIアシスタント → https://claude.ai/
- ChatGPT(OpenAI):汎用AIアシスタント → https://chatgpt.com/
- Gemini(Google):Google製のAIアシスタント → https://gemini.google.com/
参考リンク: The Decoder / Trending Topics / eSecurity Planet / Mixed / Developers Digest