【2026年9月28日発表】Claude Sonnet 5.5登場|料金据え置きで出力30%超高速・タスク単価最大30%減、Terminal-Bench 4.0でOpus 5.5を上回る|GPT-6 Solと徹底比較
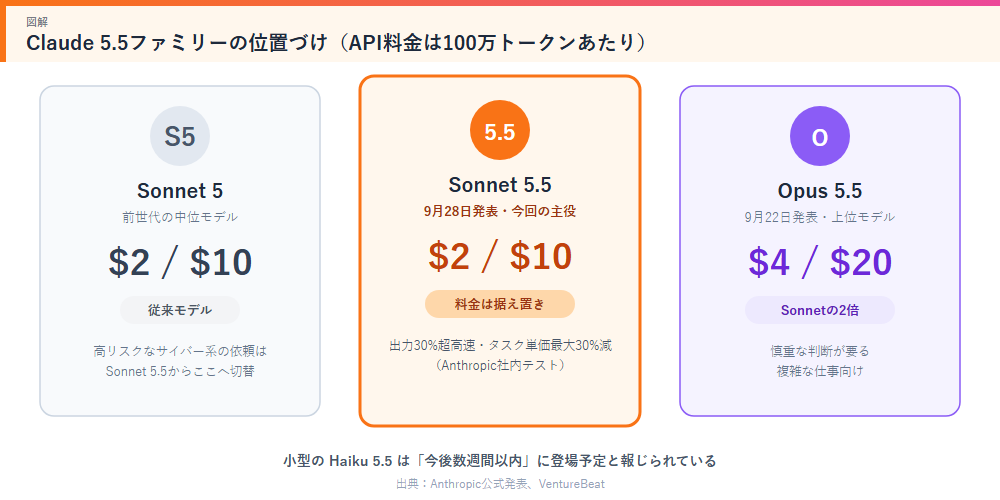
API料金は前モデルSonnet 5と同じ入力$2・出力$10(100万トークンあたり)に据え置き。そのうえでAnthropicは、出力の速さが30%以上向上し、1つの仕事あたりのコストは最大30%下がると説明している。
この記事を読むと、Sonnet 5.5で何が変わったのか、上位モデルOpus 5.5やOpenAIのGPT-6 Solとどう違うのか、そして新たに入った安全対策の中身がわかる。
① まず概要:「値段はそのまま、速く・安上がりに」
Claudeには、用途や性能、コストの異なる複数のモデルがある。現在はFable 5.1やMythos 5.1(一部は用途を限った提供)、Opus 5.5などが並び、小型のHaiku 5.5も今後加わる予定だ。
その中でAnthropicは、Sonnet 5.5を「慎重な判断が必要な複雑な仕事向けのOpus 5.5を補う、より速く低コストなモデル」と位置づけている。得意分野として挙げているのは、範囲がはっきりした日常業務、バグ修正、見栄えの良い文書・スライド・表計算の作成で、デザインを見る目も鋭いとしている。
| 項目 | 内容 |
|---|---|
| 発表日 | 2026年9月28日 |
| 位置づけ | Claude 5.5ファミリーの2機種目(1機種目はOpus 5.5) |
| モデルID | claude-sonnet-5-5 |
| API料金(100万トークンあたり) | 入力 $2/出力 $10Sonnet 5と同額 |
| キャッシュ料金 | 読み取り $0.20/書き込み $2.50 |
| 速さ | 出力生成がSonnet 5より30%以上高速 |
| コスト | 1タスクあたり最大30%減Anthropic社内テスト |
| 提供先 | Claude Platform(API)、Amazon Web Services、Google Cloud、Microsoft Azure |
| データ保持 | ゼロデータ保持(ZDR)での利用に対応 |
※ Anthropic公式発表、VentureBeat、The Decoderの報道に基づく。
② 「値下げなしで30%安くなる」とはどういうことか
今回いちばん誤解されやすいのが、この点だ。API料金の単価(1トークンあたりの値段)は1円も下がっていない。それでもAnthropicが「最大30%安くなる」と言うのは、同じ仕事を終えるまでに使うトークン(文字数のような単位)と、道具(ツール)を呼び出す回数が減ったからだ。
たとえるなら、タクシーの運賃表は変わらないが、運転手が近道を覚えたので目的地までの料金が安くなる、というイメージに近い。AIエージェントのように何十回も考えたり道具を使ったりする使い方ほど、この効果は大きく出やすい。
VentureBeatによると、先行して試した企業からは次のような声が出ている。
- Box:処理が2.4倍速くなり、使用トークンの合計は12%少なかった
- Zendesk:問い合わせチケットの処理が20%速くなった
- Slack:出力トークンがおよそ14%減り、必要な手順も少なくなった
- Lovable:ツール呼び出しが約3分の1減り、コマンド実行はおよそ半分になった
- Base44:118件のアプリ作成で、完成までのやり直し回数が平均3.6回(Opus 5は7.7回)
またAnthropicは、いくつかのベンチマーク(性能テスト)ではSonnet 5.5を低め(LowまたはMedium)の「努力度」設定で動かしても、Sonnet 5の最高スコアを上回り、しかもタスクあたりのコストは約10分の1になるとも説明している。努力度とは、AIがどれだけ時間をかけて考えるかを調整するダイヤルのような設定だ。
「最大30%減」はAnthropic社内のテスト結果で、独立した検証はこれからだ。実際、Decryptによると独立評価機関のArtificial Analysisは、努力度を最大にしたSonnet 5.5が1タスクあたり約19万3,000トークンを使い、同機関の計測対象の中でも非常に多い消費量だったとしている。つまり設定次第では逆にトークンを多く使う。「どの努力度で使うか」がコストを左右すると考えておくのが安全だ。
③ 性能:半額のSonnetが、上位のOpus 5.5に肉薄
Anthropicが公表した比較表を見ると、Sonnet 5.5は前モデルSonnet 5から大きく伸び、多くの項目で2倍の料金のOpus 5.5に迫っている。特にエージェント型のコーディング(AIが自分でコマンドを打ちながらプログラムを直す作業)を測るTerminal-Bench 4.0では70.6%と、Opus 5.5(努力度Xhigh)の66.4%を上回った。
| ベンチマーク(測るもの) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0(エージェント型コーディング) | 70.6%最高 | 10.3% | 66.4% | ― |
| FrontierCode 1.1 Main(難しいコーディング) | 46.2% | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0(実務のコード編集) | 55.5% | 34.1% | 57.8% | ― |
| GDPval-AA v2.1(仕事の成果物の質) | 1844 | 1449 | 1846 | 1487 |
| Humanity's Last Exam(ツールあり) | 64.5% | 54.9% | 67.7% | ― |
| OSWorld 2.1(パソコン操作) | 80.1% | 57.0% | 81.8% | ― |
| Chartography(図表の読み取り・ツールなし) | 61.6% | 15.6% | 64.4% | 53.6% |
※ Anthropic公式発表の比較表より。「―」は公表値なし。いずれもAnthropic側の計測で、努力度の設定によって数値は変わる。独立した検証は今後。
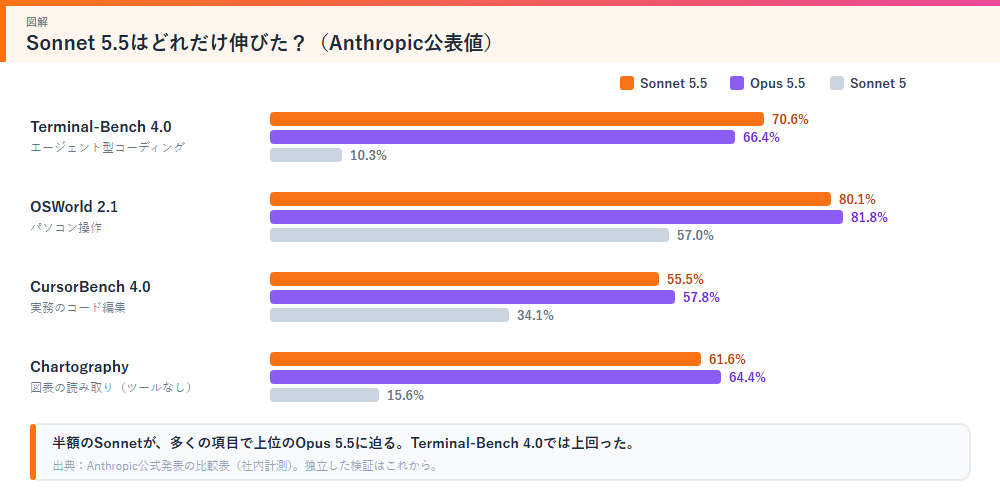
仕事の成果物の質を人の評価で比べるGDPval-AAでは、Sonnet 5.5が1844、Opus 5.5が1846とほぼ同点だ。GPT-6 Solの1487と比べても大きく上回っている。ただし、これはGDPval-AAという特定の評価での差で、総合的な優劣を示すものではない。一方、難しいコーディング課題のFrontierCodeでは、Sonnet 5.5(46.2%)はOpus 5.5(54.4%)に届かなかった。GPT-6 Sol(49.3%)との比較は努力度の設定によって順位が変わりうるため、単純比較には注意が必要だ。ここには「難しい仕事はOpus、範囲のはっきりした日常業務はSonnet」という役割分担が表れている。
独立した評価も出始めている。Decryptなどの報道によると、Artificial Analysisが独自の条件で行った計測(Terminal-Bench 4.0)ではSonnet 5.5が63.6%、Opus 5.5が59.6%、GPT-6 Astraが59.1%だった。Anthropic公表の70.6%とは実行条件が異なる別の計測で、比較相手もGPT-6 Solではなく上位のGPT-6 Astraである点に注意したい。ほかにもAnthropicは、Sonnet 5.5が画面のスクリーンショットだけを頼りにゲーム「ポケットモンスター 赤」をクリアした初めてのSonnetモデルだと紹介している。長時間にわたる作業の持続力と、画像を理解する力を示す例としている。
④ 料金比較:Opus 5.5の半額、GPT-6 Solと同じ値段
料金面では、Sonnet 5.5はOpus 5.5のちょうど半額。また、OpenAIが9月22日に発表したGPT-6 Sol(入力$2・出力$10)と同じ価格帯になった。より安さを求めるなら、OpenAIには小型のGPT-6 Luna(入力$0.10・出力$0.50)もある。
| モデル | 入力 | 出力 | 位置づけ |
|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | NEW 日常業務・エージェント向けの主力 |
| Claude Sonnet 5 | $2 | $10 | 前モデル(高リスク時の切替先) |
| Claude Opus 5.5 | $4 | $20 | 複雑で慎重な判断が必要な仕事向け |
| OpenAI GPT-6 Sol | $2 | $10 | OpenAIの主力(9月22日発表) |
| OpenAI GPT-6 Luna | $0.10 | $0.50 | 低価格の小型モデル |
※ Anthropic公式発表、VentureBeat、Engadgetの報道に基づく。キャッシュ料金などの細かな条件は各社の料金ページを確認のこと。
単価が同じなら、実際の請求額を決めるのは「1つの仕事を終えるまでに何トークン使うか」だ。Anthropicが単価ではなくタスクあたりの効率を強調しているのは、この点で差をつけたいという狙いがあると読める。なお、Claude CodeやClaudeアプリでは努力度の既定値が「Medium」、Claude Platform(API)では「High」とされている。APIで費用を抑えたい場合は、努力度の設定を自分で調整する必要がある点も覚えておきたい。小型のHaiku 5.5も今後数週間以内に登場する見込みと報じられている。
⑤ 新しい安全対策:高リスクのサイバー関連依頼は「Sonnet 5」に切り替わる
性能と並んで注目されているのが、安全対策の変更だ。Anthropicによると、Sonnet 5.5はサイバーセキュリティの能力がOpus 5に匹敵する水準に達したため、最も高性能なモデル向けに開発してきたのと同様の安全対策と切り替えの仕組みを備えた、初めてのSonnetモデルになった。
具体的には、リスクが高いと判断されたサイバー関連の作業は、目に見える形でSonnet 5に切り替えて処理される。つまり「Sonnet 5.5を選んだのに、実際の回答は一つ前のSonnet 5が返す」場面がありうる。The New Stackはこの点を「Sonnet 5.5を選んでも、AnthropicがSonnet 5に送る場合がある」と見出しで伝えている。
正当な目的で脆弱性の調査などを行うセキュリティ専門家向けには、「Cyber Verification Program(サイバー検証プログラム)」が用意されており、Anthropicはその拡充も予定しているという。生物学分野の安全対策はSonnet 5と同じで、対象は限られた高リスクの依頼に絞られている(研究者向けにはLife Sciences Verification Programがある)。
さらに、AIの「考える過程」を外部から抜き出して他社のモデルの学習に使う、いわゆる蒸留攻撃を防ぐための分類器(自動で見分ける仕組み)も新たに導入された。
一般的な文書作成やプログラミングで切り替えが起きることはまれとみられるが、セキュリティ診断のような作業をSonnet 5.5で自動化している場合は、回答の質が変わる可能性がある。切り替えは「目に見える形」で行われるとされているので、ログを確認しておくとよい。
⑥ まとめ:日常業務はSonnet 5.5、複雑な判断はOpus 5.5という使い分けへ
この記事のまとめ
- Anthropicが9月28日にClaude 5.5ファミリー2機種目のClaude Sonnet 5.5を発表
- API料金は入力$2・出力$10で据え置き。Opus 5.5の半額、GPT-6 Solと同額
- 出力は30%以上高速、使うトークンと道具の呼び出しが減りタスク単価は最大30%減(社内テスト)
- Terminal-Bench 4.0で70.6%とOpus 5.5(Xhigh:66.4%)を上回り、GDPval-AAでもほぼ同点(いずれもAnthropic公表値)
- Sonnetとして初めてサイバー安全対策を搭載。高リスクのサイバー関連依頼はSonnet 5へ切替
今回のSonnet 5.5は、「値下げ」ではなく「同じ値段でたくさん・速くこなせる」という形でコストを下げてきたのが特徴だ。Anthropic自身もSonnet 5.5を範囲のはっきりした日常業務向け、Opus 5.5を慎重な判断が必要な複雑な仕事向けと位置づけており、用途に応じて両者を使い分ける形が想定されている。一方で、数字の多くはAnthropic自身の計測で、努力度の設定によってはトークン消費が大きく増えるという独立機関の指摘もある。実際に使う際は、自分の用途で速さと費用を確かめながら設定を選ぶのがよさそうだ。
おすすめAIツール
- Claude(Anthropic):今回発表のSonnet 5.5を搭載した対話AI → https://claude.ai/
- Claude Platform(Anthropic API):開発者向けにSonnet 5.5を利用 → https://www.anthropic.com/api
- ChatGPT(OpenAI):GPT-6 Solを搭載した比較対象のAI → https://chatgpt.com/
- Gemini(Google):調べ物や資料整理に強いAI → https://gemini.google.com/
参考リンク: Anthropic公式 / VentureBeat / The Decoder / Decrypt / The New Stack