【2026年9月22日発表】Claude Opus 5.5登場|Fable 5.1級の性能で実行コスト約40%減・API料金20%値下げ|GPT-6 Sol・Opus 5と徹底比較
Anthropicによれば、多くの作業で最上位モデルClaude Fable 5.1とほぼ同じ水準の性能を出しながら、典型的な作業では前モデルOpus 5より実行コストが約40%少ないという。
この記事では、料金がいくら下がったのか、「約40%減」の中身は何か、ベンチマークの数字、そして同じ日に発表されたOpenAIのGPT-6 Solとどちらが得なのかまでを整理する。
① まず概要:Claude Opus 5.5とは何か
Claude Opus 5.5は、7月に登場したClaude Opus 5の後継にあたるモデルだ。Anthropicは長時間にわたって自律的に進める「エージェント型」のコーディングや、資料作成・分析などの知的作業向けに設計したと説明している。
提供はAnthropic自身のClaude Platform(API)に加え、Amazon Web Services、Google Cloud、Microsoft Azureでも同日から始まった。開発者向けのモデルIDはclaude-opus-5-5。Claudeの有料プラン(Pro・Max・Team・Enterprise)でも利用できると報じられている。
Anthropicは、中位モデルのClaude Sonnet 5.5と軽量モデルClaude Haiku 5.5も「数週間以内」に続けて出す予定としている。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年9月22日 |
| 提供元 | Anthropic |
| 位置づけ | Claude 5.5ファミリーの第1弾 |
| モデルID | claude-opus-5-5 |
| 扱える文章量 | 約100万トークン(コンテキスト)/最大出力12.8万トークン |
| 思考モード | 常時オン(オフにできない) |
| 提供先 | Claude Platform/AWS/Google Cloud/Microsoft Azure |
| 今後の予定 | Sonnet 5.5・Haiku 5.5が数週間以内に登場予定 |
② 料金はどう変わった:単価20%減+キャッシュ60%減
API料金は、100万トークンあたり入力$4/出力$20。Opus 5の$5/$25から、入出力とも20%の値下げになった。
特に下げ幅が大きいのが「キャッシュ読み取り」だ。これは同じ長い資料や指示を繰り返し読ませる時の割引料金で、$0.50から$0.20へ60%値下げされた。社内マニュアルや大きなプログラムを毎回読み込ませるような使い方では、この効果が大きい。
| 項目 | Opus 5 | Opus 5.5 | 削減率 |
|---|---|---|---|
| 入力 | $5.00 | $4.00 | 20%減 |
| 出力 | $25.00 | $20.00 | 20%減 |
| キャッシュ書き込み | $6.25 | $5.00 | 20%減 |
| キャッシュ読み取り | $0.50 | $0.20 | 60%減 |
| 高速モード(入力/出力) | - | $8.00 / $40.00 | 最大2.5倍速 |
※ Anthropic公式発表・料金ページの情報をもとにした目安。実際の請求は利用形態により異なる。
③ 「約40%減」の中身:使うトークン自体が減った
見出しの「約40%減」は、単価の値下げ(20%)だけの話ではない。Anthropicは、Opus 5.5が同じ仕事をより少ない手数で終わらせるようになったと説明している。
- コーディング作業で使う出力トークンが約50%減
- エージェント型コーディングでAPI呼び出し回数が40%減
- 出力の生成速度が約30%高速に
- 中くらいの努力度設定で、Opus 5の高努力度と同等の結果を出力トークン20〜25%少なく出せる
つまり「1回あたりの単価が下がった」うえに「必要な回数・文字数も減った」ため、合計の実行コストが典型的な作業で約40%下がる、という計算だ。早期に試した企業からも、Optiverが「Opus 5と同等の品質を約半分のターン・時間・トークンで達成し、コストを40〜50%削減できた」とコメントしている。
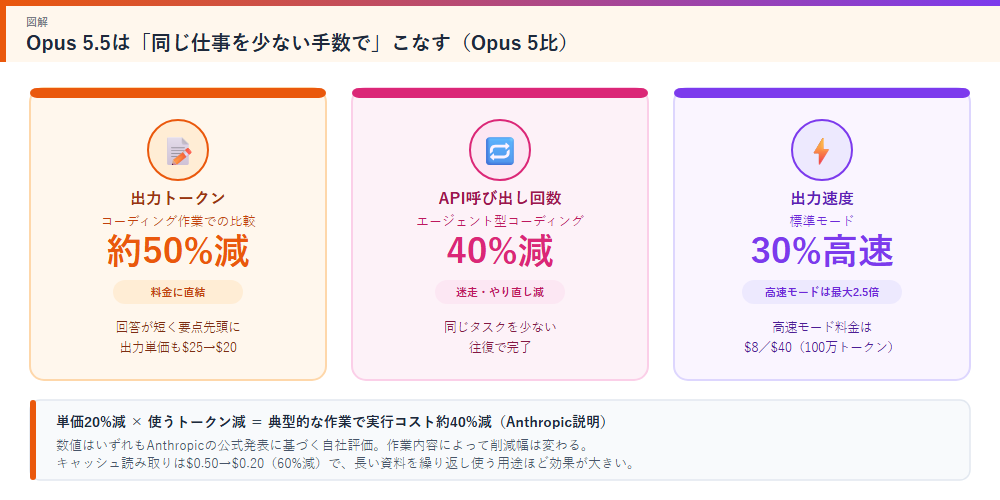
「約40%減」はAnthropicが示す「典型的な作業」での目安であり、どんな使い方でも必ず40%安くなるわけではない。短い質問を1回だけ投げるような用途では、単価の20%減が中心になると考えたほうがよい。
④ 性能はどうか:Terminal-Benchで最上位2モデルを上回る
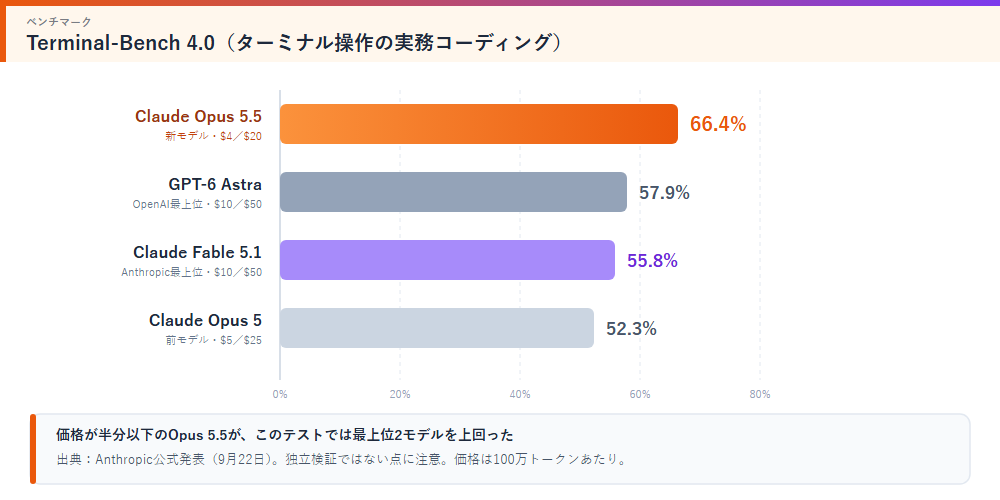
Anthropicが公開したベンチマークでは、Opus 5.5は多くの項目で前モデルOpus 5を大きく上回った。ターミナル(コマンド画面)での実務的なコーディング力を測るTerminal-Bench 4.0では66.4%と、Anthropic最上位のFable 5.1(55.8%)やOpenAIのGPT-6 Astra(57.9%)より高い数字を出している。
| ベンチマーク | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0(実務コーディング) | 66.4% | 55.8% | 52.3% | 57.9% |
| CursorBench 4.0(コーディング) | 57.8% | 51.8% | 46.6% | - |
| GDPval-AA v2.1(知的労働・Elo) | 1846 | 1735 | 1708 | 1542 |
| Humanity's Last Exam(難問) | 67.7% | 65.6% | 63.6% | 57.2% |
| OSWorld 2.0(PC操作) | 81.8% | 80.7% | 74.0% | - |
| AutomationBench(業務自動化) | 40.0% | 31.4% | 26.9% | 41.4% |
※ 数値はすべてAnthropicの公式発表による。「-」は発表資料に記載なし。第三者による独立検証ではない。
一方で、業務自動化を測るAutomationBenchではGPT-6 Astra(41.4%)がわずかに上回っており、すべての項目で勝っているわけではない。実際の利用例としては、Deloitteがコードレビューで既知のバグの72%を検出(Opus 5は56%)したと報告し、別のテスターは68万行のコード移行を1日かからずに終えたとしている。
⑤ 使う前に知っておきたい変更点と安全対策
開発者にとって注意が必要な変更もある。最も大きいのは、「思考モード」が常時オンになり、オフにできなくなった点だ。APIで思考を無効にする設定を送るとエラーになり、考える深さは「努力度(effort)」の設定で調整する方式に一本化された。また、ツールの使い方を強制指定する一部の設定や、古いバージョンのコンピューター操作ツールもエラーになる。既存のシステムからOpus 5.5へ切り替える場合は、事前にテストしておくと安心だ。
安全面では、サイバーセキュリティに関わる作業の多くを自動的にClaude Opus 4.8に切り替えて処理する仕組みが入った。普段の開発で行うバグ修正は引き続きOpus 5.5で扱えるが、攻撃に悪用されうる高度な作業は制限される形だ。専門家向けには審査制の「Cyber Verification Program」を拡充するとしている。生物学分野でも同様の切り替えがあり、審査を通った研究機関向けには「Life Sciences Verification Program」が用意される。
Anthropicは、約2,000の場面で行った自社の行動監査で「これまでで最も良いスコア」を記録し、制限の外に出ようとする行動はOpus 5より約85%少なかったと説明している。
⑥ まとめ:GPT-6 Solとの料金比較と今後の見どころ
同じ9月22日には、OpenAIも中位モデルGPT-6 Solを$2/$10で発表している。基準価格だけを並べると、次のような位置関係になる。
Claude Fable 5.1とGPT-6 Astraが$10/$50、Claude Opus 5.5が$4/$20、Claude Sonnet 5とGPT-6 Solが$2/$10。Opus 5.5はGPT-6 Solの2倍の単価だが、Anthropicは最上位モデル並みの性能を最上位の半分以下の価格で出せる点を強みとしている。価格だけでなく、使うトークン量や作業の成功率まで含めた「1件あたりのコスト」で比べることが大切だ。
この記事のまとめ
- AnthropicがClaude Opus 5.5を公開(2026年9月22日)。Claude 5.5ファミリーの第1弾
- API料金は$5/$25→$4/$20(20%減)、キャッシュ読み取りは60%減
- 出力トークン約50%減・API呼び出し40%減により、典型的な作業の実行コストはOpus 5比で約40%減(Anthropic説明)
- Terminal-Bench 4.0で66.4%など、多くの項目でFable 5.1・GPT-6 Astraを上回ると発表(自社評価)
- 思考モードは常時オン。サイバー関連の作業はOpus 4.8へ自動切り替え。Sonnet 5.5・Haiku 5.5は数週間以内に登場予定
OpenAIのGPT-6 Sol/Lunaの恒久値下げと、AnthropicのOpus 5.5の登場が同じ週に重なり、AIモデルの競争は「性能」だけでなく「同じ仕事をいくらで終えられるか」に移りつつある。次に出るSonnet 5.5・Haiku 5.5の価格と性能にも注目したい。
おすすめAIツール
- Claude(Anthropic):今回Opus 5.5を提供するAIアシスタント → https://claude.ai/
- Claude Platform(開発者向け):APIでOpus 5.5を使う場合の公式ドキュメント → https://platform.claude.com/docs
- ChatGPT(OpenAI):GPT-6 Sol/Astraとの比較に → https://chatgpt.com/
- Perplexity AI:最新AIニュースの調査・裏取りに → https://www.perplexity.ai/
参考リンク(公式・主要メディア): Anthropic 公式発表 / Claude Platform リリースノート / The Mac Observer / Technology.org