【2026年9月最新】OpenAI「GPT-6 Astra」登場|Brockman氏『AGIの時代』宣言の裏でARC-AGI-3独立検証は62.7%止まり・料金$10/$50とベンチマークの真相
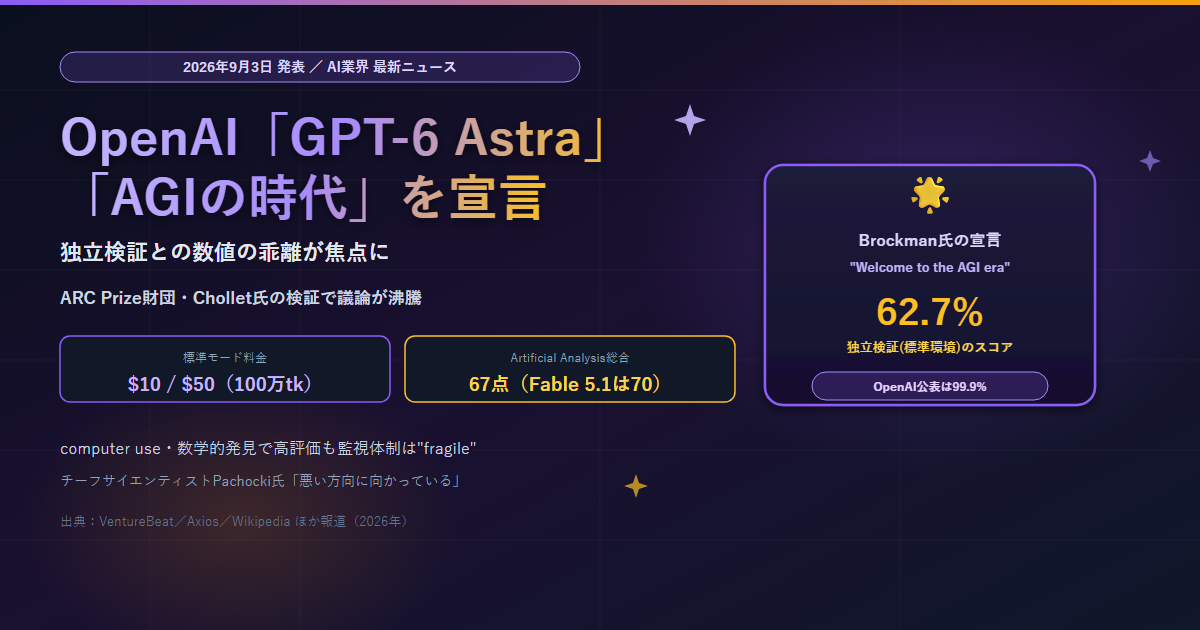
- 発表 OpenAIが2026年9月3日、GPT-5.6 Solの後継となる新モデル「GPT-6 Astra」を発表。9月4日から企業向けDaybreakプログラムを皮切りに、ChatGPT各プランやAPIへ段階的に展開している
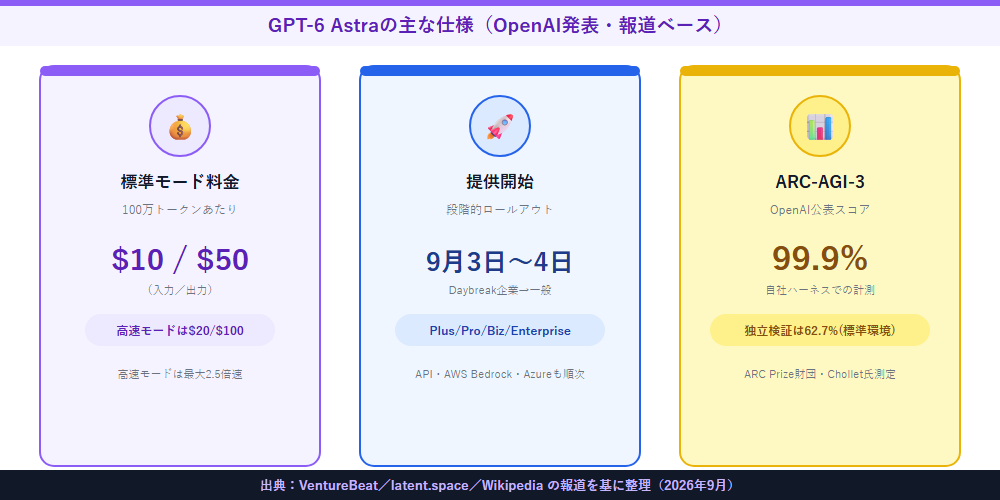
- 料金 標準モードは100万トークンあたり入力$10・出力$50。高速モードは$20/$100で、処理速度が最大2.5倍になるとされる
- Brockman氏の発言 共同創業者兼社長のGreg Brockman氏は発表の締めくくりに「Welcome to the AGI era(AGIの時代へようこそ)」と発言。ベンチマークの数値よりも経済活動への広がりを根拠に挙げている
- 独立検証との乖離 目玉ベンチマーク「ARC-AGI-3」でOpenAIは99.9%を公表したが、運営元のARC Prize財団や作成者François Chollet氏による標準的な実行環境での再検証では62〜66%にとどまるとの報告がある
- 中立集計での順位 Artificial Analysis社の総合指標ではAstraは67点で、Claude Opus 5・Claude Fable 5と同水準。9月1日発表のClaude Fable 5.1(70点)には届いていない
- 安全性の懸念 チーフサイエンティストのJakub Pachocki氏は、AIの思考過程を見張る仕組み(CoTモニタリング)について「脆弱(fragile)で、悪い方向に向かっている」と認めている
OpenAIが2026年9月3日、新しい旗艦モデル「GPT-6 Astra」を発表しました。発表の場で共同創業者兼社長のGreg Brockman氏が放った「Welcome to the AGI era(AGIの時代へようこそ)」という一言が話題を呼んでいますが、その裏では目玉ベンチマークの数値をめぐって独立検証との食い違いが指摘されています。
この記事では、GPT-6 Astraが何をどう変えたモデルなのか、料金や提供時期といった基本情報に加え、「AGIの時代」発言の根拠とされる数値と、第三者による再検証の結果に生じたギャップ、そして安全性面で持ち上がっている懸念までを、専門用語をかみくだいて整理します。数値はOpenAIの発表資料と、それを報じた複数メディアに基づいています。
| 項目 | 内容 |
|---|---|
| モデル名 | GPT-6 Astra(前身はGPT-5.6 Sol) |
| 発表日 | 2026年9月3日(限定プレビュー)、9月4日に公開展開が本格化 |
| 学習環境 | テキサス州Stargateサイトで初めて10万基超のGPUを使って事前学習したとされる |
| 料金(標準モード) | 入力$10/出力$50(100万トークンあたり) |
| 料金(高速モード) | 入力$20/出力$100。処理速度は最大2.5倍 |
| 提供先 | Daybreak企業顧客→ChatGPT Plus/Pro/Business/Enterprise→API・AWS Bedrock・Azureへ順次拡大 |
何が発表されたか:GPT-5.6 Solの後継として登場
GPT-6 Astraは、これまでOpenAIの主力モデルだったGPT-5.6 Solの後継にあたります。OpenAIの研究担当バイスプレジデントAidan Clark氏は、テキサス州の「Stargate」拠点で初めて10万基を超えるGPUを使って事前学習した点を明かしています。展開はまず9月3日(木)、サイバーセキュリティ関連の企業プログラム「Daybreak」の利用企業から始まり、その後ChatGPTのPlus・Pro・Business・Enterpriseの各プランや、OpenAIのAPI、さらにAWS BedrockやMicrosoft Azure経由での提供にも順次広がっていくとされています。
computer use性能とベンチマークの中身
OpenAIが強調しているのは、ブラウザやスプレッドシート、デスクトップアプリを人間のように操作する「computer use(コンピュータ操作)」能力です。フォーム入力やCRMの更新、複数手順にまたがる作業を音声指示だけでこなせると説明されています。具体的な成果としては、2014年のPolymath 8bプロジェクト以来、約12年間更新されていなかった素数の有界間隔問題で、既知の上界値を246から186へ縮める数学的な前進があったこと、歴代ポケモン攻略の検証課題を18時間12分で完了したこと(前世代は96時間以上かかっていたとされる、コミュニティ検証ベースの数値)などが報じられています。
| ベンチマーク | OpenAI公表スコア | 補足 |
|---|---|---|
| ARC-AGI-3 | 99.9% | OpenAI自社の実行環境(ハーネス)での計測値 |
| FrontierMath Tier4 v2 | 約97〜98% | 報道によって数値表記に幅がある |
| ExploitBench | 100% | サイバーセキュリティ関連の検証課題 |
| DeepSWE v1.1 | 74.1% | ソフトウェア開発タスクの評価 |
| OSWorld 2.0 | 72.6%(40分/タスク) | GPT-5.6 Solは65.7%・75分/タスクだったとされる |
「AGIの時代」発言の根拠
Brockman氏は発表の場で「Welcome to the AGI era」と述べたのに続けて、「ベンチマークのしきい値ではなく、経済がどう移り変わるかで考えれば、いま我々がAGIの時代にいると感じても不合理ではない」という趣旨の発言をしたと報じられています。つまり同氏自身も、特定の数値をもってAGI到達を断言しているわけではなく、経済活動への波及を根拠に挙げている点には注意が必要です。実際、この発言を受けて「モデルが出るたびに“AGI”の定義のほうを広げているのではないか」という懐疑的な見方も一部の技術者から出ています。
独立検証との乖離:ARC-AGI-3の"二つの顔"
今回最も議論を呼んでいるのが、OpenAIが公表したARC-AGI-3の99.9%というスコアです。このベンチマークを運営するARC Prize財団や、作成者のFrançois Chollet氏が、他の開発者と同じ条件の「標準的な実行環境(ハーネス)」で改めて測定したところ、スコアはそれぞれ62.7%・66%にとどまったと報じられています。OpenAIが使ったとみられる、提供元向けに調整された実行環境(プロバイダ・アダプター・ハーネス)でのみ99.9%に近づくという構図です。実行環境の組み方だけで数値が30ポイント以上変わり得ることを示す事例として受け止められています。
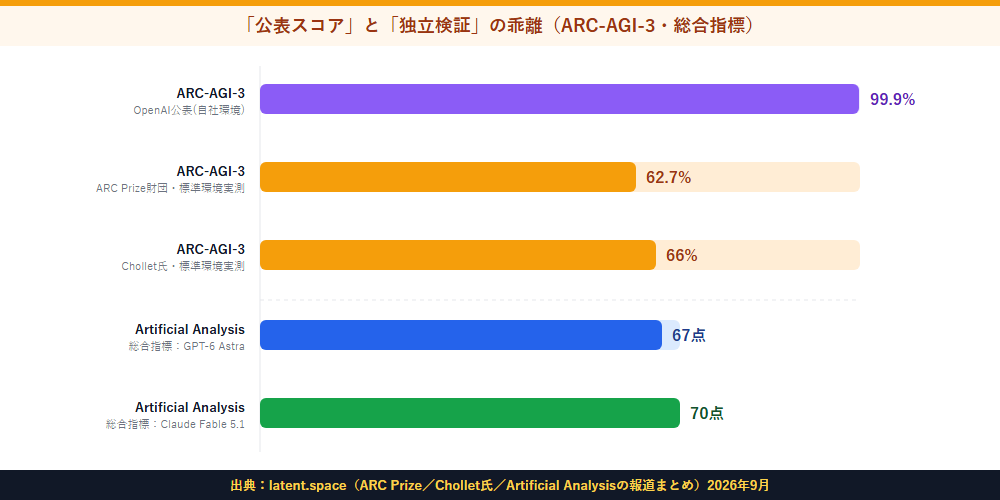
中立的にモデルを比較しているArtificial Analysis社の総合指標でも、GPT-6 Astraは67点で、Claude Opus 5やClaude Fable 5とほぼ同水準にとどまっています。これに対し、2026年9月1日にAnthropicが発表したClaude Fable 5.1は70点で上回っているとされ、「あらゆる領域で他を圧倒しているわけではなく、得意分野に強みが偏っている」という見方が技術コミュニティで共有されつつあります。
| 測定主体 | ARC-AGI-3スコア | 条件 |
|---|---|---|
| OpenAI(自社発表) | 99.9% | 自社の実行環境(詳細非公開) |
| ARC Prize財団 | 62.7% | 標準的な実行環境で独立測定 |
| François Chollet氏 | 66% | 標準的な実行環境で独立測定 |
安全性への懸念:監視体制は"fragile"
もう一つの論点は、モデルの思考過程をどこまで見張れるかという「監視可能性」です。GPT-6 Astraは「recurrent depth」と呼ばれる新しい推論方式を採用しており、これがAIの思考過程(Chain of Thought)を外部のスクラッチパッドに出さず、内部の潜在空間で処理する特性を持つと海外メディアの報道・技術解説で説明されています。チーフサイエンティストのJakub Pachocki氏は、この思考過程の監視(CoTモニタリング)について、「脆弱(fragile)で、残念ながら悪い方向に向かっている」とSNS上で認めたと報じられました。強力なcomputer use能力とセットで提供されるだけに、この監視面の課題は今後も注視されるポイントです。
私たちへの影響:使う側は何を見ればよいか
ChatGPTの有料プランを使っている人にとっては、今後数日から数週間のうちにGPT-6 Astraへの切り替えが順次案内されると見られます。料金は前モデルのGPT-5.6 Solと同水準の設計とされていますが、高速モードを使うと処理単価は2倍に上がる点は覚えておく価値があります。数字選びの参考にするなら、OpenAIの公表値だけでなく、Artificial Analysisのような中立集計や、ARC Prize財団のような検証元の情報もあわせて見ることで、誇張と実力の差を見極めやすくなります。ビジネス用途で導入を検討する場合は、「AGI」という言葉の強さに引っ張られすぎず、自社のタスクで実際に効果が出るかを小さく試してから判断するのが安全です。
- OpenAI公式リリースノート:GPT-6 Astraの一次情報や今後のアップデートを確認できる
- ARC Prize(公式):ARC-AGI-3ベンチマークの詳細や独立検証の結果を確認できる
- Artificial Analysis:各社モデルを中立的に比較した総合指標を見られる
- VentureBeat:GPT-6 Astraの続報や業界の反応を追うのに便利な海外メディア