【2026年9月最新】Claude Fable 5.1/Mythos 5.1登場|キャッシュ読み取り75%値下げで実質コスト最大45%減・研究ベンチマークが前世代比2倍超に
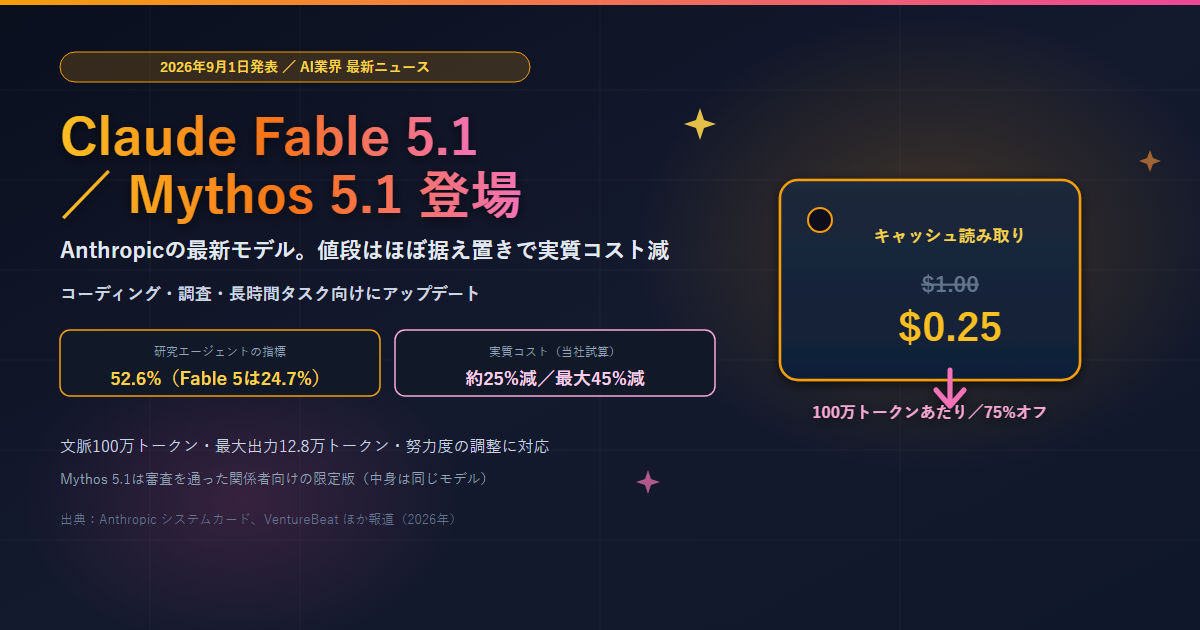
- 発表 Anthropic(アンソロピック)が2026年9月1日、コーディングと知的作業向けの新モデル「Claude Fable 5.1(フェイブル)」と「Claude Mythos 5.1(マイソス)」を公開した
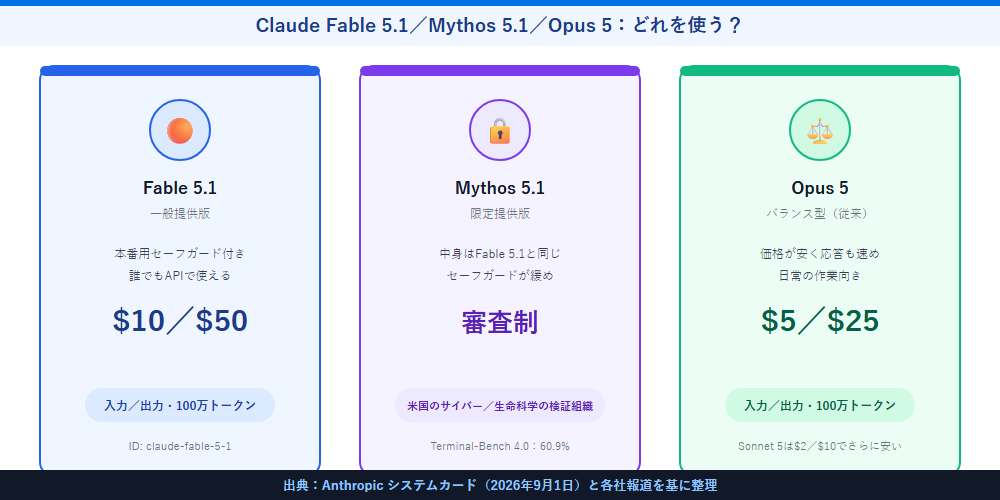
- 関係 2つは同じ基盤モデル。Fable 5.1が誰でも使える一般提供版、Mythos 5.1はサイバーセキュリティと生命科学の分野で審査を通った関係者・組織(現時点では米国が中心)向けの限定版で、安全装置の掛かり方が違う
- 料金 入力100万トークンあたり10ドル、出力50ドルは据え置き。一方で「キャッシュ読み取り」が1.00ドルから0.25ドルへ75%下がり、典型的な使い方で実質コストが約25%、AIに何度も往復させるエージェント用途では最大45%下がるとAnthropicは説明している
- 性能 研究作業を代行させるテスト「Terminal-Bench-Science 0.1」がAnthropicの公表値で24.7%から52.6%へ2倍超に上昇。同社は「今回公表したベンチマーク比較では旧上位モデルのOpus 5をすべて上回った」としている
- 安全 サイバー分野でのセーフガードによる介入が平均約60%減、生物学分野の良性の質問への過剰反応が約85%減。生成テキストに見えない電子透かしが入る
Anthropicが2026年9月1日、Claudeの新モデル「Fable 5.1」と「Mythos 5.1」を発表しました。番号どおり、6月に出た「Fable 5」の小数点アップデートにあたります。目立つ新機能が並ぶ派手な発表ではありませんが、「同じ値段でより多くの仕事をこなす」「AIに長い作業を任せるときの請求額が下がる」という、実利に直結する変更が入っています。
この記事では、Fable 5.1とMythos 5.1がどういう関係なのか、料金の何がどう変わったのか、性能はどこまで伸びたのか、そして私たちの使い方にどう影響するのかを、専門用語をかみくだいて整理します。数値はすべてAnthropicの公式システムカードと、それを報じた複数メディアに基づいています。
| 項目 | 内容 |
|---|---|
| 発表元/発表日 | Anthropic(米国のAI企業)/2026年9月1日 |
| モデル名 | Claude Fable 5.1(一般提供)/Claude Mythos 5.1(限定提供)。API上のIDは「claude-fable-5-1」 |
| 位置づけ | コーディング・調査・長時間タスク向けの最上位クラス。6月の「Fable 5」の改良版 |
| 文脈・出力 | 入力100万トークン/1回の出力は最大12.8万トークン。努力度(effort)は5段階(low/medium/high/xhigh/max)で調整可能。知識のカットオフは2026年6月 |
| 料金(100万トークン) | 入力10ドル/出力50ドル(据え置き)。キャッシュ読み取りは1.00ドル→0.25ドルに値下げ |
| 提供場所 | Claude API、Claude Code、Claude Cowork、Claude.ai、Amazon Bedrock、Google Cloud、Microsoft Foundry |
まず結論:基本料金は据え置き、キャッシュを多く使う作業ほど実質コストが下がる
今回の目玉は、新しい能力よりも「支払いの仕組み」です。AIに文章を読ませたり書かせたりすると、その分量(トークン)に応じて料金がかかります。Fable 5.1では、この基本料金である入力10ドル・出力50ドル(いずれも100万トークンあたり)は変わっていません。
変わったのは「キャッシュ読み取り」の料金です。AIとの長いやり取りでは、毎回すべての文脈を最初から読み直すのは無駄なので、前回読んだ内容を一時的に保存(キャッシュ)して使い回す仕組みがあります。この「保存済みの内容を読み出す」料金が、100万トークンあたり1.00ドルから0.25ドルへと75%下がりました。Anthropicは、2026年8月の実利用データを基にした試算として、キャッシュを使う典型的な使い方なら実質コストが約25%、AIに何度も自律的に作業を往復させるエージェント用途なら最大45%下がると説明しています。逆に、キャッシュをほとんど使わない単発の利用では、入力・出力の料金自体は変わっていない点には注意が必要です。
Fable 5.1とMythos 5.1は「同じモデル・別のセーフガード」
今回は名前が2つ同時に出たので混乱しやすいのですが、Fable 5.1とMythos 5.1は同じ基盤モデルです。Anthropicは「同じモデルに、異なる水準のセーフガード(安全装置)を適用したもの」と説明しています。
Fable 5.1は一般提供版で、Anthropicの本番用セーフガードがそのまま効いています。たとえばサイバー攻撃の実地演習(ペネトレーションテスト)や、生命科学の研究開発にあたる質問は、より制限の厳しいOpus系モデルへ回すよう設計されています。一方のMythos 5.1は、そうしたセーフガードを緩めた限定版で、サイバーセキュリティと生命科学の分野で正規の検証プログラムを通過した関係者・組織だけがアクセスできます(Anthropicの案内では現時点は米国が中心)。「防御目的で本物の脆弱性を深く調べたい」といった、通常は制限がかかる用途を担うための窓口という位置づけです。一般のユーザーや企業が普通に使うのはFable 5.1のほうだと考えて差し支えありません。
| モデル(100万トークン) | 入力 | キャッシュ読み取り | 出力 |
|---|---|---|---|
| Claude Fable 5.1(今回) | 10ドル | 0.25ドル(75%値下げ) | 50ドル |
| Claude Fable 5(6月) | 10ドル | 1.00ドル | 50ドル |
| Claude Opus 5 | 5ドル | 0.50ドル | 25ドル |
| Claude Sonnet 5 | 2ドル | 0.20ドル | 10ドル |
※Fable 5.1はバッチ処理(急がない大量処理)を使うと入力・出力がさらに半額の5ドル/25ドルになります。Fable系はあくまで最上位クラスで、日常的な用途ではより安いOpus 5やSonnet 5が引き続き基本の選択肢です。
何が変わったか①:長時間タスクの「積み上がる請求」を抑える
キャッシュ読み取りの値下げが効くのは、AIに長い作業を任せる場面です。たとえばコードベース全体を読ませてバグを直させる、大量の資料を渡して調査レポートを書かせる、といった作業では、AIが同じ文脈を何十回も読み直します。従来はその読み直しのたびにキャッシュ読み取り料金が積み上がっていました。
今回その単価が4分の1になったことで、「AIエージェントに長時間まかせると請求が怖い」という悩みが和らぎます。Anthropicは、Fable 5.1は前バージョンより効率良く動くため、Claude Codeでの1セッションあたりの平均コストも下がると説明しています。ただし、これはあくまで「1トークンあたり」や「読み直しあたり」が安くなったという話です。AIがより多くのステップを踏んで丁寧に作業するようになれば、使うトークンの総量が増えて、結果的な合計額は作業内容しだいで上下します。
何が変わったか②:研究・長時間タスクの性能が伸びた
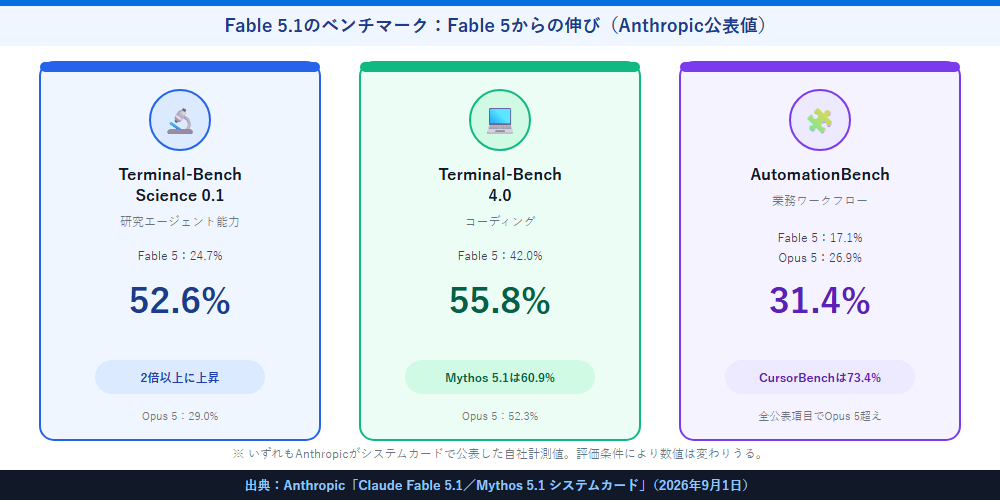
性能面では、AIに研究作業を代行させる「Terminal-Bench-Science 0.1」というテストのスコアが、Fable 5の24.7%からFable 5.1では52.6%へと2倍以上に上がりました(いずれもAnthropicの公表値)。比較対象として、Opus 5は29.0%、OpenAIのGPT-5.6 Solは22.4%と示されています。コンピュータ上で手を動かして調べ物や実験手順を進める、という粘り強さが伸びた形です。
コーディング能力を測る「Terminal-Bench 4.0」も42.0%から55.8%へ改善し、限定版のMythos 5.1は60.9%と報告されています。このほか、開発支援ツール上での実力を測る「CursorBench」が73.4%、業務ワークフローの自動化を測る「AutomationBench」が31.4%(Fable 5は17.1%、Opus 5は26.9%)です。Anthropicは「今回の発表で公表したベンチマーク比較では、Fable 5.1がすべてOpus 5を上回った」としています。従来はOpus 5が一部の項目でFable 5より上だったため、この世代交代で序列が整理された形です。
| ベンチマーク(測る能力) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1(研究の代行) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0(コーディング) | 55.8% | 42.0% | 52.3% | 37.3% |
| CursorBench 3.2.0(開発支援ツール上の実力) | 73.4% | 70.5% | 70.0% | 67.2% |
| AutomationBench(業務ワークフロー) | 31.4% | 17.1% | 26.9% | 19.6% |
| GDPval-AA v2(知的作業の総合・Elo) | 1,853 | 1,723 | 1,824 | 1,711 |
何が変わったか③:安全対策の「過剰な拒否」を減らした
もう一つの変更が、安全装置のチューニングです。これまでのClaudeは、危険な使い方を防ぐために、実際には無害な質問まで拒否したり中断したりすることがありました。Anthropicは今回、その「行き過ぎ」を減らしたと説明しています。
具体的には、サイバーセキュリティ分野で、Claude Code利用中のセーフガードによる介入が1セッションあたり平均で約60%減ったとしています。生物学分野でも、初歩的で良性の質問に安全装置が作動する頻度が約85%下がったとされます。危険な依頼をブロックする方針は保ったまま、まっとうな研究者や開発者の作業を邪魔しにくくする、という調整です。あわせて、Fable 5.1が生成するテキストには、人間の目には見えない統計的な電子透かしが入ります。これはEUのAI法(透明性要件)への対応にあたるもので、Anthropicは「コンテンツの来歴表示は任意ではない(必須だ)」としています。
私たちの使い方はどう変わる?
まとめると、今回のアップデートで実利があるのは主に次のような人です。
- 開発者・エンジニア Claude Codeなどで大きなコードベースを扱い、AIに長時間の作業を任せている人。キャッシュ読み取りの値下げで、同じ作業の請求額が下がりやすい
- 調査・分析の仕事 大量の資料を読ませてレポートを書かせる使い方。研究代行系の性能が伸びており、途中で息切れしにくくなったとされる
- セキュリティ・研究職 これまで安全装置に阻まれがちだった正当な作業。誤ブロックが減り、業務が進めやすくなる可能性がある
一方で、短い質問中心の使い方なら、価格の安いOpus 5やSonnet 5も有力な選択肢です。Fable 5.1の高い単価に見合うのは「長く・深く・自律的に」働かせる場面だといえます。まずは手元の使い方がどちらに近いかを見極め、エージェント的な使い方をしているなら、モデルをFable 5.1に切り替えて請求額の変化を確認してみる、というのが現実的な進め方です。
- Anthropic「Claude Fable」(公式):Fableシリーズの概要ページ。用途や位置づけの一次情報
- Anthropic News(公式):発表やシステムカードの告知が載る。原文で数値を確認したいときに
- Claude 料金ドキュメント(公式):モデル別の入力・出力・キャッシュ料金の最新一覧
- Claude Code(公式):今回の値下げの恩恵が大きい、ターミナル上のAIコーディング環境