【2026年8月最新】OpenAIが「Ultrafastモード」を先行公開|GPT-5.6 Solを最大14倍速・毎秒750トークンで動かすCerebras製の新API
- 発表 OpenAIは2026年8月13日、AI半導体企業Cerebras(セレブラス)と組み、APIの新しいサービス階層「Ultrafast(ウルトラファスト)モード」を先行公開した
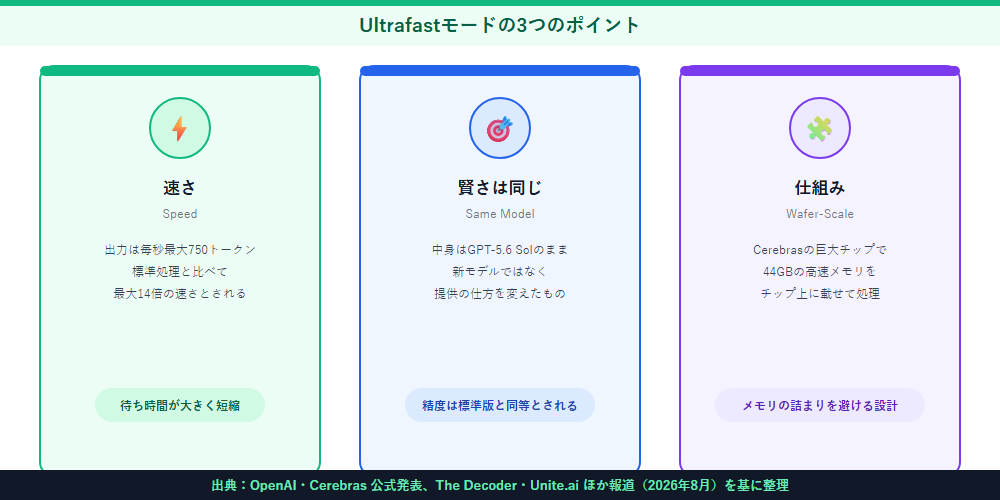
- 速さ 旗艦モデル「GPT-5.6 Sol」を、標準処理の最大14倍・毎秒最大750出力トークンで動かせるとされる
- 中身 新しいモデルではなく、「同じGPT-5.6 SolをCerebrasの大型チップで動かす提供形態」。知能・精度は標準版と変わらないと説明されている
- 仕組み 速さの源は、44GBの高速メモリ(SRAM)をチップ上に載せ、一般的なGPUで起きるメモリの詰まりを避ける設計
- 現状 いまは順番待ち制の限定プレビューで、料金は未公表。一般提供の時期も示されていない
OpenAI(オープンエーアイ)は2026年8月13日、AI向け半導体を手がけるCerebras Systemsと連携し、APIの新しい提供メニュー「Ultrafastモード」を先行公開(プレビュー公開)したと発表した。OpenAI公式ページ「Previewing Ultrafast」やCerebrasの発表のほか、The Decoder・Unite.aiなど複数の技術メディアが報じている。
ポイントは、これが「新しいAIモデル」ではなく「既存のGPT-5.6 Solを、これまでよりずっと速く応答させるための実行環境」だという点だ。この記事では、Ultrafastモードが何なのか、なぜ速いのか、どれくらい速いのか、そして何に向いているのかを、専門用語をかみくだいて整理する。
| 項目 | 内容 |
|---|---|
| 発表日 | 2026年8月13日 |
| 提供元 | OpenAI(推論の高速化はCerebras Systemsが担当) |
| 対象モデル | GPT-5.6 Sol(OpenAIの旗艦モデル)。新モデルではなく提供形態の追加 |
| 速さ | 標準処理の最大14倍、出力は毎秒最大750トークンとされる |
| 使うチップ | Cerebrasのウェハースケール・エンジン(ウェハー1枚を丸ごと使う大型チップ) |
| 提供状況 | 順番待ち制の限定プレビュー。一部の顧客から順次拡大予定 |
| 料金 | 未公表(2026年8月下旬時点) |
まず概要:GPT-5.6 Solを「最大14倍速」で動かす新API
生成AIを使うとき、答えが1文字ずつ表示されて「書き終わるのを待つ」感覚があると思う。この「1秒あたりに何文字(何トークン)出せるか」が応答の速さで、Ultrafastモードはここを一気に引き上げるものだ。OpenAIによれば、GPT-5.6 Solの出力速度は毎秒最大750トークン、標準の処理と比べて最大14倍になるという。
トークンは、AIが文章を扱うときの細かい単位で、日本語ではおおむね1〜2文字くらいに相当する。毎秒750トークンは、体感としては「ページがほぼ一瞬で埋まる」レベルの速さだ。ただしこの数値は上限値(最大)であり、実際の速さは処理内容や混雑状況で変わる点には注意がいる。
Ultrafastモードとは:知能はそのまま、速さだけ上げる
ここが誤解されやすいところだが、Ultrafastは「賢くなった新モデル」ではない。OpenAIとCerebrasは、Ultrafastを「新モデルではなくサービス階層(提供メニュー)であり、同じGPT-5.6 SolをCerebrasのウェハースケール・ハードウェア上で動かしたもの」と説明している。
OpenAIとCerebrasは、標準版と同じGPT-5.6 Solの知能を保ったまま、品質を落とさずに速さだけを引き上げたと説明している。根拠として、知識労働の生産性をはかる「GDP-Val」というベンチマークで、最初から最後まで通した処理がおよそ5.6倍速くなり、しかも品質の低下はなかったとしている。ただしこれは提供側による説明・評価であり、第三者が同じ条件で検証したものではない点は割り引いて読む必要がある。
| 観点 | 標準のGPT-5.6 Sol | Ultrafastモード |
|---|---|---|
| モデルの中身 | GPT-5.6 Sol | 同じGPT-5.6 Sol(変更なし) |
| 答えの質 | 基準 | 標準版と同等と説明されている |
| 出力の速さ | 基準 | 最大14倍、毎秒最大750トークンとされる |
| 動かすチップ | 主にGPU | Cerebrasのウェハースケール・エンジン |
| 使える人 | APIの一般利用者 | 順番待ち制の限定プレビュー参加者 |
| 料金 | 公表済み(GPT-5.6 Solの通常価格) | 未公表 |
なぜ速いのか:Cerebrasの「ウェハースケール」チップ
速さの理由は、使っているチップの構造にある。ふつうのAI用GPUは、計算するチップと、データを置いておくメモリが分かれていて、その間でデータをやり取りする。生成AIの応答生成では、モデルの「重み(パラメータ)」をメモリから何度も読み出す必要があり、この読み出しの帯域(通り道の太さ)が渋滞の原因になりやすい。これを「メモリ帯域のボトルネック」と呼ぶ。
Cerebrasのチップは、シリコンウェハー1枚をほぼ丸ごと1個のチップとして使う「ウェハースケール・エンジン」という設計で、44GB(ギガバイト)ぶんの高速メモリ(SRAM)をチップの上に載せている。大容量の高速メモリをチップ上に備えることで、推論時のデータのやり取りを減らし、メモリの通り道を活かしやすくなる。結果として、1トークンずつ生成していく処理が速くなる、という理屈だ。
どれくらい速いのか:ベンチマークの数字
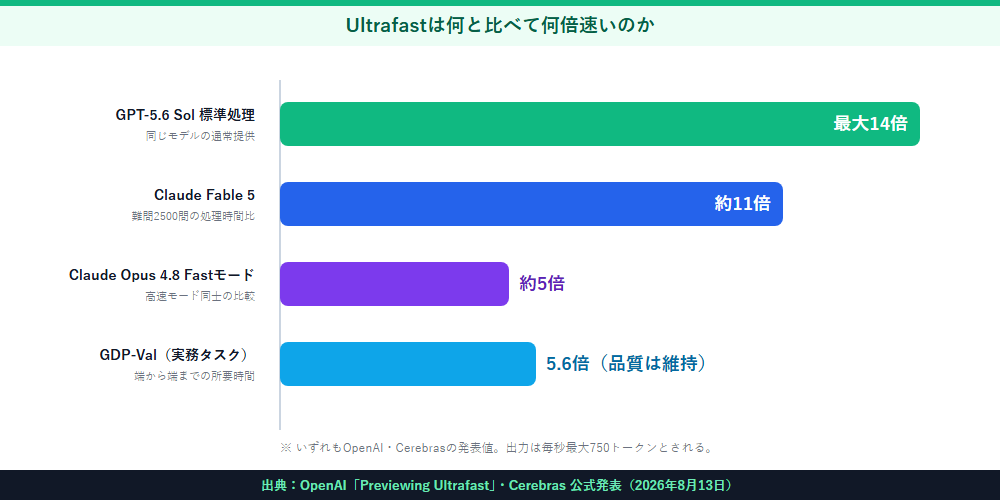
OpenAIとCerebrasが示した比較値を整理すると、次のようになる。標準のGPT-5.6 Sol比で最大14倍、Anthropicの「Claude Fable 5」比でおよそ11倍、「Claude Opus 4.8」の高速モード比でおよそ5倍、とされる。
具体的なタスクの例として、博士課程レベルの難問を集めた「Humanity's Last Exam」の2,500問を処理したところ、GPT-5.6 SolのUltrafastは11時間11分で完了し、比較対象のClaude Fable 5は78時間27分かかった、という数字が示されている。これは所要時間でおよそ7倍の差にあたる。ただし、ここまでの「最大14倍」「約11倍」「約5倍」「5.6倍」といった数値は、いずれもOpenAIおよびCerebrasが公表したベンダー側の測定値で、第三者が同一条件で再現・検証したものではない。公表値として受け止める必要がある。
| 比較の相手 | 速さの差(発表値) | 補足 |
|---|---|---|
| GPT-5.6 Sol 標準処理 | 最大14倍 | 同じモデルの通常提供との比較 |
| Claude Fable 5 | 約11倍 | 難問2,500問の処理では所要時間で約7倍差 |
| Claude Opus 4.8(高速モード) | 約5倍 | 高速モード同士の比較 |
| GDP-Val(実務寄りの評価) | 約5.6倍 | 端から端まで通した処理。品質は維持と説明 |
何に使えるのか:向いている場面と現状の制約
OpenAIは、Ultrafastが効きやすい用途として、コーディング(プログラム作成)、コマース(ネット通販の処理)、金融リサーチ、カスタマーサポート、システム障害の対応、サイバー脅威の検知、法務向けの文書作成、エンジニアリングのレポート作成などを挙げている。いずれも「人やシステムが答えを待っている時間が短いほど価値が上がる」タイプの仕事だ。
たとえば対話しながらコードを書く場面では、返答が速いほど試行錯誤の回数を増やせる。障害対応やセキュリティのように一刻を争う場面でも、分析結果が早く出るほど復旧が早まる。逆に、夜間にまとめて処理するバッチ作業のように「待てる」仕事では、速さのメリットは相対的に小さい。
制約もはっきりしている。現時点では順番待ち制の限定プレビューで、誰でもすぐ使えるわけではない。料金も未公表で、一般提供の時期も示されていない。Cerebrasの大型チップは供給量に限りがあるため、拡大のペースは「容量が増え次第」とされている。
まとめ:AI競争の軸が「賢さ」から「速さ」にも広がる
この記事のまとめ:
- OpenAIは2026年8月13日、Cerebrasと組んでAPIの新階層「Ultrafastモード」を先行公開した
- 中身は既存のGPT-5.6 Solで、OpenAI・Cerebrasは「答えの質は変えずに出力速度を最大14倍・毎秒最大750トークンに引き上げた」と説明している
- 速さの理由は、44GBの高速メモリをチップ上に載せたCerebrasのウェハースケール・エンジンで、メモリの渋滞を避けられること
- コーディング、障害対応、サイバー防衛、金融リサーチなど「待ち時間が短いほど価値が上がる」用途に向く
- いまは順番待ち制の限定プレビューで、料金・一般提供時期は未公表(未公表であって無料という意味ではない)。速度の数値はすべてベンダー公表値で、第三者検証はこれから
なお、Ultrafastの発表と同じ2026年8月13日には、GoogleもGemini 3.7 Flashを発表しており、こちらは前世代の半額の導入価格が打ち出されている。AIモデルの競争は「どこまで賢いか」だけでなく「どれだけ速く・安く答えを返せるか」も重要な土俵になりつつある。Ultrafastモードは、その流れをOpenAIとCerebrasが「専用チップ」というかたちで一段進めた事例だといえる。一般提供の条件と料金が明らかになったとき、実際にどこまで使われるかが次の焦点になる。
- OpenAI「Previewing Ultrafast mode」(公式):今回の発表の一次情報。速度の数値や対象用途が説明されている
- Cerebras Systems(公式):ウェハースケール・エンジンを開発するAI半導体企業。技術ブログで仕組みを解説している
- OpenAI API ドキュメント:APIの使い方や利用可能なモデル・階層を確認できる
- Perplexity AI:新しい発表の裏取りや複数メディアの比較に便利な調査向けAI